Bygg din egen AI-verkstad
Hårdvaran, programmen och budgeten för att köra språkmodeller, agenter och AI-jobb hemma eller på företaget.
En användbar AI-dator behöver inte vara ett serverrack. Men rätt köp börjar med arbetsuppgiften, inte grafikkortet. Här är en praktisk väg från första lokala modellen till en säker företagsinstallation – och en genomgång av vad du faktiskt får jämfört med molnets största AI-system.
 Av Johan LindqvistSkribent · Verktyg och praktik
Uppläst av tidningens berättarröst
En servicetekniker vill kunna fråga företagets reparationsmanualer utan att skicka dem till en extern tjänst. En utvecklare vill ha kodhjälp även när nätet ligger nere. En ekonom vill sortera fakturaunderlag under natten. Tre rimliga skäl att köpa en AI-dator – och tre uppgifter som ställer ganska olika krav på den.
Det är här många inköp börjar i fel ände. Ett dyrt grafikkort beställs innan någon har undersökt vilken modell som behövs, hur många personer som ska använda den eller om uppgiften egentligen löses bättre med ett vanligt program.
Den viktigaste skillnaden går inte mellan hemma och företag. Den går mellan att experimentera, att använda ett verktyg själv och att driva en tjänst som andra ska kunna lita på.
Den här guiden utgår från öppna modeller och verktyg dokumenterade under 2024–2025. Budgetarna är grova svenska planeringsintervall inklusive moms, inte aktuella offerter. Prestanda varierar kraftigt mellan modellversioner och programvaror. Inga egna hårdvarutester redovisas här; i stället får du ett arbetssätt för att mäta på dina egna uppgifter innan du köper.
1. Bestäm jobbet innan du bygger datorn
Att ”köra AI” kan betyda flera saker. Vanligast är inferens: att använda en redan tränad modell för att producera text, analysera bilder eller transkribera ljud. Det är fullt möjligt på konsumenthårdvara.
Att träna en stor generell språkmodell från grunden är något helt annat. Det kräver enorma datamängder, beräkningsresurser och utvecklingsinsatser. En lokal AI-dator är framför allt en maskin för att använda modeller, ibland även för begränsad finjustering.
Börja därför med att skriva en arbetsbeskrivning som går att kontrollera: ”Läs en svensk servicerapport, extrahera maskinnummer och föreslå rätt avsnitt i manualen.” Det är mycket bättre än ”Vi behöver en egen ChatGPT”.
Dela sedan upp behovet i fyra typer:
- Interaktiv assistent: du ställer frågor och väntar på svar. Kort väntetid är viktig.
- Dokumentarbete: modellen söker, sammanfattar och jämför interna underlag. Dokumenthantering och källstöd är centrala.
- Batchjobb: hundratals texter eller ljudfiler behandlas utan att någon sitter och väntar. Genomströmning och återstartbarhet väger tyngre.
- Agentarbete: modellen får använda verktyg, exempelvis söka filer, köra tester eller skapa ärenden. Behörigheter och felhantering blir avgörande.
En agent är inte nödvändigtvis en större modell. Det är ett system där en modell kombineras med program, instruktioner och en körslinga: tolka uppdraget, föreslå nästa steg, anropa ett verktyg, läsa resultatet och fortsätta.
För företaget tillkommer antalet samtidiga användare. Tio anställda som använder assistenten sporadiskt är inte samma belastning som tio automatiska processer som arbetar oavbrutet. Dimensionera efter samtidighet och svarstider, inte bara antal konton.
Gör också en dataklassning. Vilka dokument får skickas till en extern tjänst? Vilka får lämna en viss dator? Vilka får över huvud taget bli sökbara för andra anställda? Lokal körning är ett sätt att kontrollera dataflöden, men den ersätter varken åtkomstkontroll eller juridisk bedömning.
Köp inte först en AI-dator och leta sedan efter ett användningsområde. Bygg först ett litet prov med verkliga uppgifter – och låt resultatet bestämma hårdvaran.
2. Hårdvaran: minnet avgör vad som får plats
För språkmodeller är grafikkortets minne, VRAM, ofta den första begränsningen. Grafikprocessorn utför beräkningarna, men modellens vikter måste också få plats någonstans. Om delar hamnar i vanligt arbetsminne kan systemet fortfarande fungera, men med betydligt lägre hastighet.
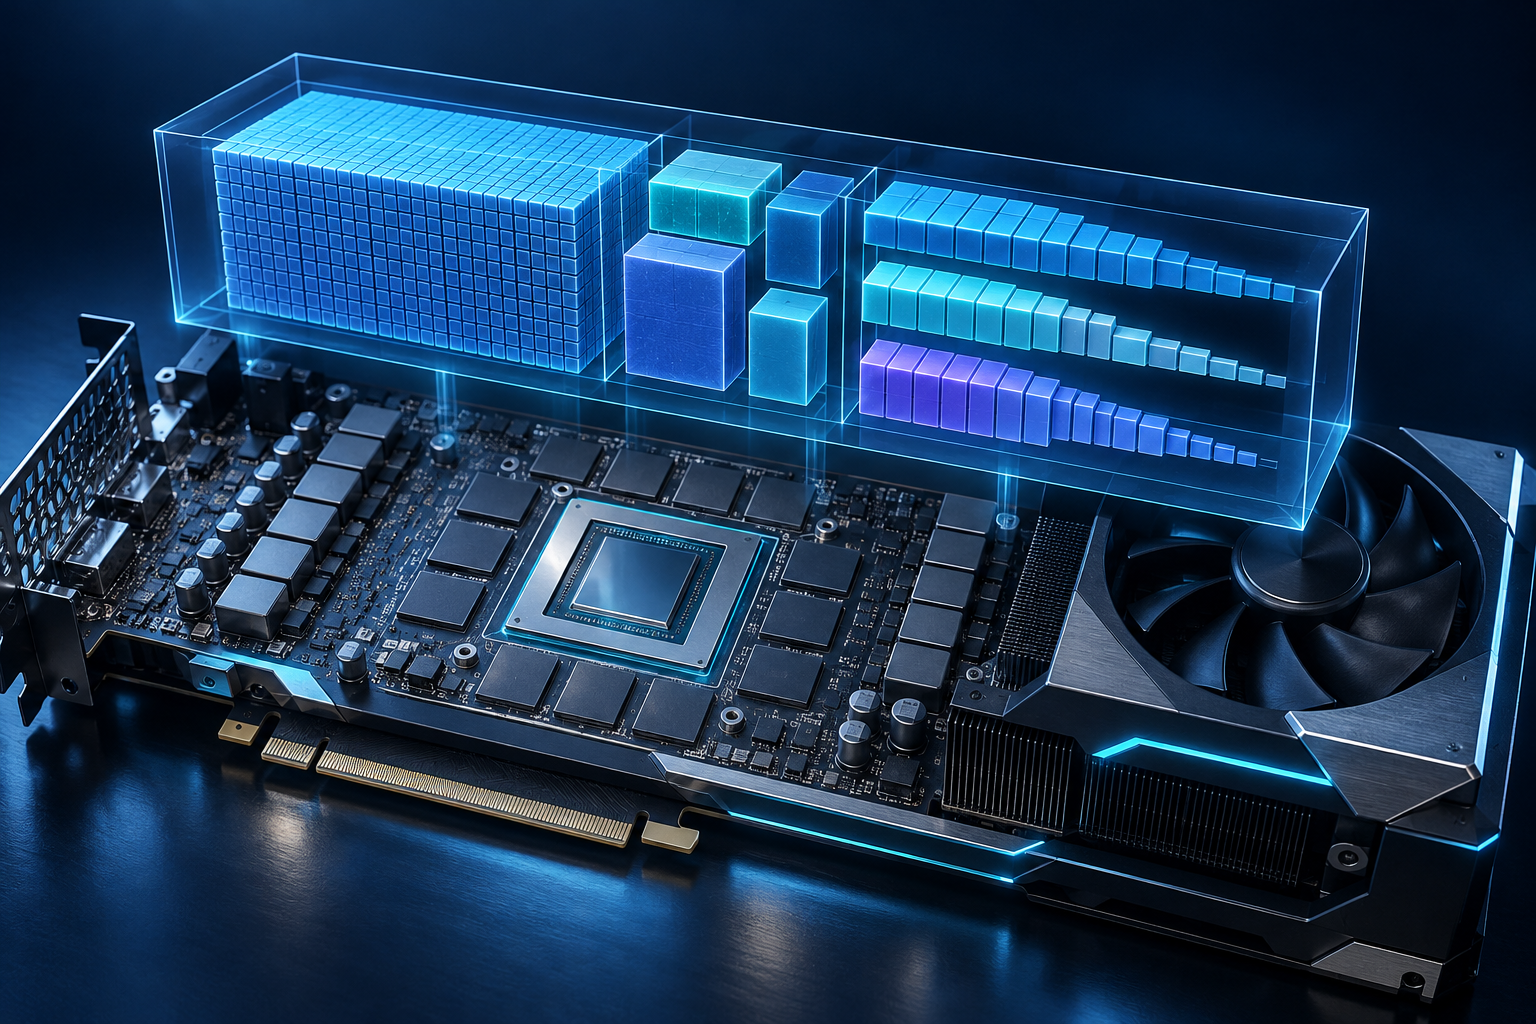
En modell med åtta miljarder parametrar behöver rent matematiskt ungefär 16 miljarder byte för vikterna vid 16 bitar per parameter. Vid fyra bitar blir motsvarande råstorlek ungefär fyra miljarder byte. Detta är inte det totala minneskravet. Kvantiseringsmetadata, arbetsbuffertar och modellens minne för pågående samtal tillkommer.
Att minska precisionen på detta sätt kallas kvantisering. Det gör stora modeller praktiskt användbara på mindre datorer, men kan försämra kvaliteten. Hur mycket beror på modellen, kvantiseringsmetoden och uppgiften. Filstorleken är därför ett startvärde, inte ett löfte om att modellen ryms och fungerar bra.
Långa dokument kostar också minne. Modellen sparar mellanresultat för texten den behandlar i en så kallad KV-cache. Längre kontext och fler samtidiga sessioner kan öka minnesbehovet kraftigt. En modell som fungerar utmärkt för korta frågor kan bli långsam eller få slut på minne när du matar in en hel rapport.
Som grov inköpskarta för kvantiserade textmodeller kan du använda följande:
8 GB grafikminne räcker till små modeller, ungefär 3–8 miljarder parametrar. Den större änden kräver försiktig kvantisering och begränsad kontext.
12–16 GB passar modeller kring 7–14 miljarder parametrar. Exakt passform beror på format, cache och andra program.
24 GB ger gott arbetsutrymme för mindre modeller och vissa kring 30–32 miljarder parametrar. Större modeller kräver låg precision och kontrollerat minnesutrymme.
48 GB eller mer behövs för större modeller eller fler parallella jobb. En modell kring 70 miljarder parametrar kan fortfarande vara trång vid lång kontext.
Tabellen är ett sätt att sålla alternativ, inte en kompatibilitetsgaranti.
Nvidia är ofta den enklaste vägen för en egenbyggd arbetsstation, eftersom många AI-verktyg har omfattande stöd för CUDA. AMD kan vara ett bra alternativ, men kontrollera exakt grafikkort, operativsystem och stöd i den programvara du tänker använda. Att ett kort är snabbt i spel säger inte att det fungerar problemfritt med din AI-stack.
Apple Silicon erbjuder en annan konstruktion: CPU och GPU använder ett gemensamt minne. En maskin med stort enhetligt minne kan därmed köra modeller som inte ryms i ett vanligt konsumentgrafikkort. Minneskapacitet är dock inte samma sak som beräkningshastighet. Jämför den faktiska modellen och arbetsuppgiften, inte bara antalet gigabyte.
För en vanlig PC är 32 GB RAM en rimlig start och 64 GB bekvämare när du arbetar med dokument, utvecklingsverktyg och flera tjänster. En NVMe-SSD på 1–2 TB ger plats för modeller och data. Flera modellversioner kan snabbt förbruka hundratals gigabyte.
Processorn behöver vara modern och kompetent, men för GPU-baserad inferens är det sällan klokt att maximera CPU-budgeten på bekostnad av grafikminnet. Kör du däremot främst på CPU blir minnesbandbredd och processor viktigare.
Glöm inte nätaggregat, kylning och ljudnivå. Ett begagnat grafikkort med 24 GB kan vara intressant, men kontrollera skick, garanti, strömanslutningar och chassimått. Två grafikkort blir inte automatiskt ett dubbelt så stort, lika snabbt kort: modellen måste kunna delas av programvaran, och kommunikationen kan bli en flaskhals.
3. Programmen: bygg en liten stack som du förstår
Den lokala AI-installationen består egentligen av flera lager: modell, körmotor, användargränssnitt och eventuella anslutningar till dokument eller verktyg. Börja med så få lager som möjligt.
För en första dator är Ollama eller LM Studio lättillgängliga alternativ. De hjälper dig att hämta och köra modeller. Ollama lämpar sig också för att ansluta egna program via ett lokalt API. LM Studio erbjuder ett grafiskt arbetssätt.
Den som vill styra mer själv kan använda llama.cpp, ett projekt med stöd för bland annat CPU-körning, GPU-avlastning och kvantiserade modeller i GGUF-format. För en server med fler samtidiga anrop är vLLM ett alternativ att utvärdera, särskilt på kompatibel GPU-hårdvara. Högre belastning motiverar en servermotor, men inte automatiskt en mer komplicerad installation från dag ett.
Ett minimalt första prov med Ollama kan se ut så här efter installation:
ollama run qwen2.5:7b
Det är ett konkret exempel ur modellutbudet från perioden, inte ett påstående om att just den modellen är bäst i dag. Kontrollera alltid modelltagg, nedladdningsstorlek och licens. Prova sedan med anonymiserade exempel från ditt eget arbete.
Behöver du en webbaserad chatt kan exempelvis Open WebUI läggas ovanpå. Ska datorn hantera tal är Whisper-familjen och optimerade implementationer relevanta att undersöka. Bildgenerering kräver andra modeller och arbetsflöden; en textmodell är inte automatiskt en bildgenerator.
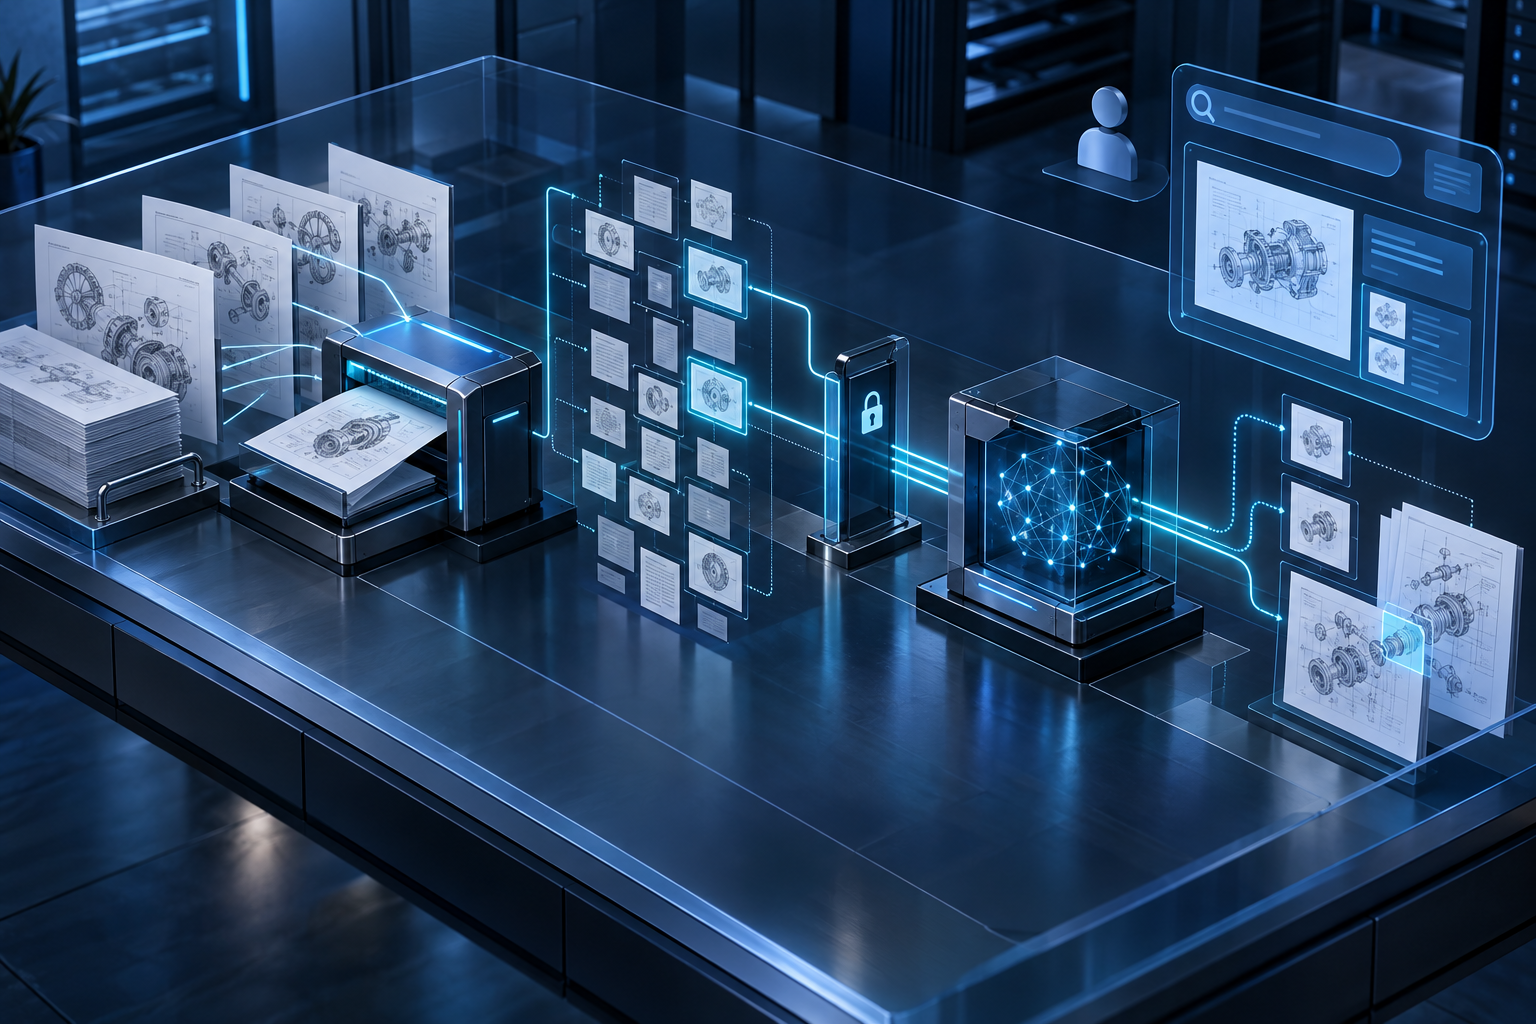
För interna dokument används ofta RAG, retrieval-augmented generation. Dokumenten delas upp i avsnitt. Ett söksystem hämtar relevanta delar, och språkmodellen får dessa som underlag när den skriver svaret. Det är inte samma sak som att träna om modellen.
Ett fungerande dokumentflöde behöver mer än en vektordatabas. Skannade PDF-filer kan kräva OCR. Tabeller måste tolkas rätt. Gamla manualer måste kunna ersättas. Filnamn, sidnummer och versionsdatum bör följa med varje textavsnitt. Annars riskerar modellen att ge ett välformulerat svar från fel produktgeneration.
Börja gärna med vanlig textsökning, eller kombinera den med semantisk sökning. Artikelnummer och felkoder matchas ofta bäst exakt. Att två meningar betyder ungefär samma sak hjälper inte om skillnaden mellan två maskinmodeller är en enda siffra.
På företaget bör modellservern ligga bakom autentisering och kontrollerad nätverksåtkomst. Exponera inte en lokal utvecklingsserver direkt mot internet. Dokumentens behörigheter måste följas redan när sökningen hämtar material, inte bara beskrivas i en instruktion till modellen.
Spara installationsanvisningar, modellversion, kvantisering och inställningar. Om resultatet ändras efter en uppdatering behöver du kunna återställa den tidigare kombinationen. Kontrollera också licenser: nedladdningsbara modellvikter innebär inte automatiskt obegränsad kommersiell användning eller full insyn i träningsdata.
4. Budgeten: tre nivåer och kostnaderna mellan raderna
Vad kostar det då? Det beror framför allt på om du redan äger en användbar dator och om du räknar din egen tid. Följande intervall är planeringsunderlag, inte prisuppgifter från en aktuell återförsäljare.
Prova på befintlig dator – 0 till 5 000 kronor i kompletteringar. Räcker för små modeller, en användare och utvärdering.
Dedikerad AI-arbetsstation – 15 000 till 35 000 kronor. För lokal assistent, dokumentjobb och enklare agenter.
Kraftigare arbetsstation – 35 000 till 80 000 kronor. Ger mer grafikminne, större modeller och tyngre arbetsflöden.
Företagsserver med högre driftkrav – 80 000 till 250 000 kronor eller mer. Professionella GPU:er, större kapacitet och service.
Intervallen överlappar. Ett begagnat grafikkort kan ge mycket minne per krona, medan en ny professionell GPU kan kosta mer än en hel konsumentdator. En liten företagsinstallation kan också fungera på en arbetsstation; serverpriset är inget inträdeskrav.
För hemmaexperiment är det rationellt att börja med den dator du har. Även långsam CPU-körning kan visa om modellen begriper uppgiften. Om kvaliteten är otillräcklig hjälper det inte att samma felaktiga svar kommer snabbare.
För en dedikerad arbetsstation bör du prioritera tillräckligt grafikminne, tillräckligt systemminne och stabil kylning framför påkostade detaljer. Köp först när du vet vilken modellstorlek som klarar ditt provmaterial.
För företaget tillkommer installation, säkerhetsgranskning, övervakning, säkerhetskopiering och underhåll. Ange vem som ansvarar när tjänsten slutar fungera. En maskin som körs under en utvecklares skrivbord kan vara en bra pilot, men är inte automatiskt en robust företagstjänst.
Elkostnaden går att räkna på utan gissningar om modellens effektivitet. Anta att hela systemet i genomsnitt drar 300 watt under åtta timmar om dagen. Det blir 2,4 kWh per dag. Vid ett antaget totalpris på två kronor per kWh motsvarar det cirka 1 750 kronor per år om det körs så varje dag. Körs samma effekt dygnet runt blir det cirka 5 260 kronor. Detta är räkneexempel, inte uppmätt förbrukning; mät vid vägguttaget.
Även kapitalet kostar. En dator för 30 000 kronor fördelad över tre år motsvarar ungefär 833 kronor i månaden före el, finansiering, underhåll och eventuellt restvärde. Lägg till administrationstiden innan du jämför med ett API.
Vid sporadisk användning kan molnet vara billigare. Vid jämn, hög belastning och uppgifter som en mindre modell klarar kan egen hårdvara vara attraktiv. Datakrav, tillgänglighet utan internet och kontroll över versioner kan också motivera lokal drift även när den inte är billigast.
5. Kvaliteten mot datorhallen: jämför hela arbetsflödet
En lokal modell är inte en kopia av molnets starkaste assistenter i ett mindre chassi. De mest avancerade molnsystemen kan kombinera större eller mer beräkningskrävande modeller med verktyg, sökning och omfattande produktutveckling. På svåra, öppna uppgifter bör du räkna med att en liten lokal modell ofta har ett underläge.
Men ”kvalitet” behöver definieras. Att extrahera tio fält ur ett standardiserat dokument är inte samma problem som att lösa ett okänt programmeringsfel. En mindre modell kan vara tillräckligt bra för det första och opålitlig för det andra.
Det finns också en viktig skillnad mellan modellens kunskap och systemets tillgång till rätt information. En lokal modell med rätt manual framför sig kan vara mer användbar än en stark molnmodell utan manualen. För en rättvis jämförelse ska båda få samma underlag och motsvarande verktyg.
Bygg ett testpaket med exempelvis 50 verkliga men lämpligt avidentifierade uppgifter. Ta med enkla fall, normala fall och sådant som brukar gå fel. För dokumentfrågor bör vissa frågor sakna svar i materialet: kan modellen säga att underlag saknas?
Mät sedan minst fem saker:
- Korrekthet: hur många svar är användbara utan rättning?
- Källstöd: finns uppgifterna faktiskt på den angivna sidan?
- Struktur: följer svaret ett bestämt schema, exempelvis giltig JSON?
- Tid: hur länge dröjer första svaret, och när är jobbet färdigt?
- Efterarbete: hur mycket mänsklig granskning återstår?
Poängsätt helst svaren utan att granskaren vet vilken modell som producerat dem. Kör agentuppgifter flera gånger eftersom olika körningar kan lyckas olika bra. Frys versioner och inställningar under jämförelsen.
Mät dessutom arbetsflödet i sin helhet. En snabb modell kan kräva många försök och ändå bli långsammare än en större modell som gör rätt direkt. Dokumentinläsning, sökning och verktygsanrop kan stå för en stor del av väntetiden.
Tokens per sekund är ett användbart tekniskt mått, men tokens är textbitar, inte ord, och hastigheten säger inget direkt om korrektheten. Dokumentera modell, kvantisering, kontextlängd, hårdvara och samtidighet när du jämför mätningar.
Den praktiska slutsatsen är att lokal AI ofta bör vara specialiserad. Låt programkod kontrollera summor, validera artikelnummer och verifiera datastrukturer. Använd språkmodellen där språklig tolkning behövs. Deterministiska kontroller runt modellen ger ofta större nytta än ett dyrare grafikkort.
6. Agenter behöver räcken, inte bara mer beräkning
Det går relativt snabbt att få en modell att skriva en verktygsbegäran. Det svåra är att göra begäran säker att verkställa.
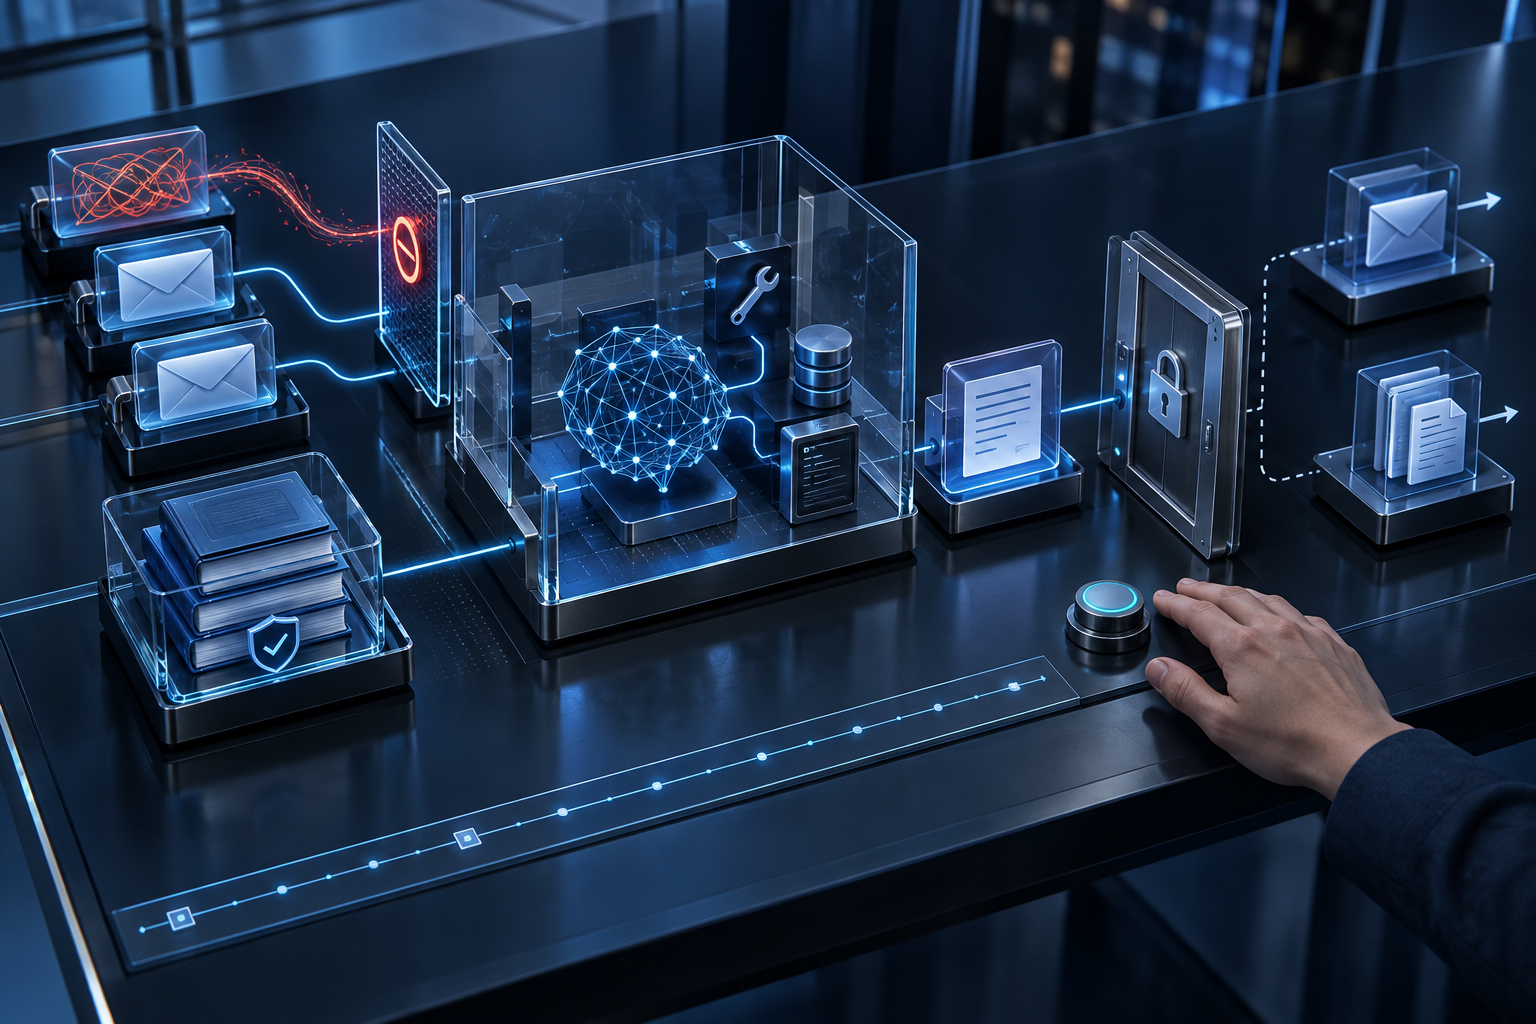
Tänk dig en agent som ska läsa en supportinkorg och föreslå åtgärder. Ett mejl kan innehålla instruktioner som försöker få modellen att ignorera regler, öppna filer eller skicka information vidare. Det är en form av promptinjektion. Att modellen körs lokalt gör inte innehållet ofarligt.
Börja därför med läsrättigheter och förslag, inte med fulla befogenheter. En användbar första agent kan läsa ett ärende, leta i godkända manualer och skapa ett utkast. En människa granskar innan något skickas eller ändras.
Inför sedan en tydlig kontrollkedja:
- Begränsade verktyg: erbjud specifika funktioner i stället för fri tillgång till kommandoskalet.
- Separata identiteter: agenten ska inte ärva administratörens behörigheter.
- Isolerad körning: kör osäker kod i en lämpligt begränsad miljö utan produktionshemligheter.
- Godkännande: kräv bekräftelse före betalningar, radering, extern kommunikation och känsliga ändringar.
- Stoppvillkor: begränsa antal steg, körtid och tillåtna resurser.
- Spårbarhet: logga verktygsanrop och resultat, med skydd och gallring för känsliga uppgifter.
Programmet som verkställer anropet måste kontrollera argumenten. Att modellen föreslår en filväg innebär inte att den får läsa den. Att ett svar har rätt JSON-format innebär inte att innehållet är korrekt eller tillåtet.
För återkommande uppdrag är en fast process ofta bättre än en fritt planerande agent: hämta dokument, extrahera fält, validera, skicka osäkra fall till granskning. Då blir felen lättare att upptäcka och kostnaden lättare att förutsäga.
Lokal drift förbättrar möjligheten att kontrollera data, men kontrollen måste genomföras. Webbsökning, externa anslutningar, uppdateringar och telemetri kan skapa utgående trafik. Granska hela lösningen innan du beskriver den som offline eller helt lokal.
7. Framåt: köp för nästa uppgift, inte nästa löfte
Utvecklingen går i flera riktningar samtidigt. Mindre modeller blir bättre genom förbättrad träning och destillering. Kvantisering och effektivare körmotorer gör det möjligt att använda större modeller på samma minnesmängd. Samtidigt ökar ambitionerna: längre dokument, fler modaliteter och agenter som arbetar i många steg.
Det betyder att effektiviseringsvinster inte nödvändigtvis ger lägre hårdvarubehov. De kan lika gärna användas till mer arbete. När en agent provar tio lösningsvägar i stället för att skriva ett svar ökar beräkningsbehovet även om varje enskilt anrop blivit billigare.
Datorernas inbyggda NPU:er kan bli viktiga för energieffektiva bakgrundsuppgifter. Men ett högt marknadsfört TOPS-tal är inte en garanti för snabb körning av din valda språkmodell. Minneskapacitet, precision, drivrutiner och stöd i körmotorn behöver passa ihop.
Det är därför osäkert när, eller om, en viss framtida persondator kommer att motsvara framtidens bästa molnmodeller. Båda utvecklas. Planera inte ett inköp utifrån löften om att lokal superintelligens snart gör all annan programvara överflödig.
En mer robust väg är hybrid drift: lokalt för känsliga data och välavgränsade rutinuppgifter, externa tjänster där de ger dokumenterad nytta och där informationsreglerna tillåter det. Bygg gärna ett gemensamt gränssnitt så att modellvalet går att ändra utan att hela verksamhetsprocessen skrivs om.
En första pilot kan genomföras i fyra steg. Samla först testuppgifter och bestäm vad ett godkänt resultat betyder. Installera sedan en liten modell på befintlig utrustning. Lägg därefter till en enda integration, exempelvis sökning i en begränsad dokumentmapp. Jämför slutligen kvalitet, väntetid och granskningsarbete med ett molnalternativ.
Köp mer hårdvara först när du kan namnge flaskhalsen: modellen ryms inte, svarstiden är för lång eller samtidigheten är för låg. Om problemet i stället är fel manualer, otydliga instruktioner eller bristande rättigheter kommer ett större grafikkort inte att lösa det.
Den bästa AI-datorn är alltså inte den mest imponerande maskinen. Det är den minsta, säkraste och mest begripliga installation som klarar ditt verkliga arbete – och som du kan visa faktiskt gör det.
Källor
- Aaron Grattafiori med flera, The Llama 3 Herd of Models (2024)
- Qwen Team, Qwen2.5 Technical Report (2024)
- ggml-org och projektets bidragsgivare, llama.cpp (Löpande dokumentation)
- Ollama, Hardware support (Löpande dokumentation)
- Ollama, FAQ (Löpande dokumentation)
- Woosuk Kwon med flera, Efficient Memory Management for Large Language Model Serving with PagedAttention (2023)
- Patrick Lewis med flera, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- OWASP GenAI Security Project, LLM01:2025 Prompt Injection (2025)
Ställ frågor om "Bygg din egen AI-verkstad". Svaren bygger på tidningens egna artiklar.