Kan vi öppna AI:s svarta låda?
Forskarna kan hitta begrepp i språkmodeller – och vrida på dem. Men vägen till en fullständig säkerhetsbesiktning är fortfarande lång.
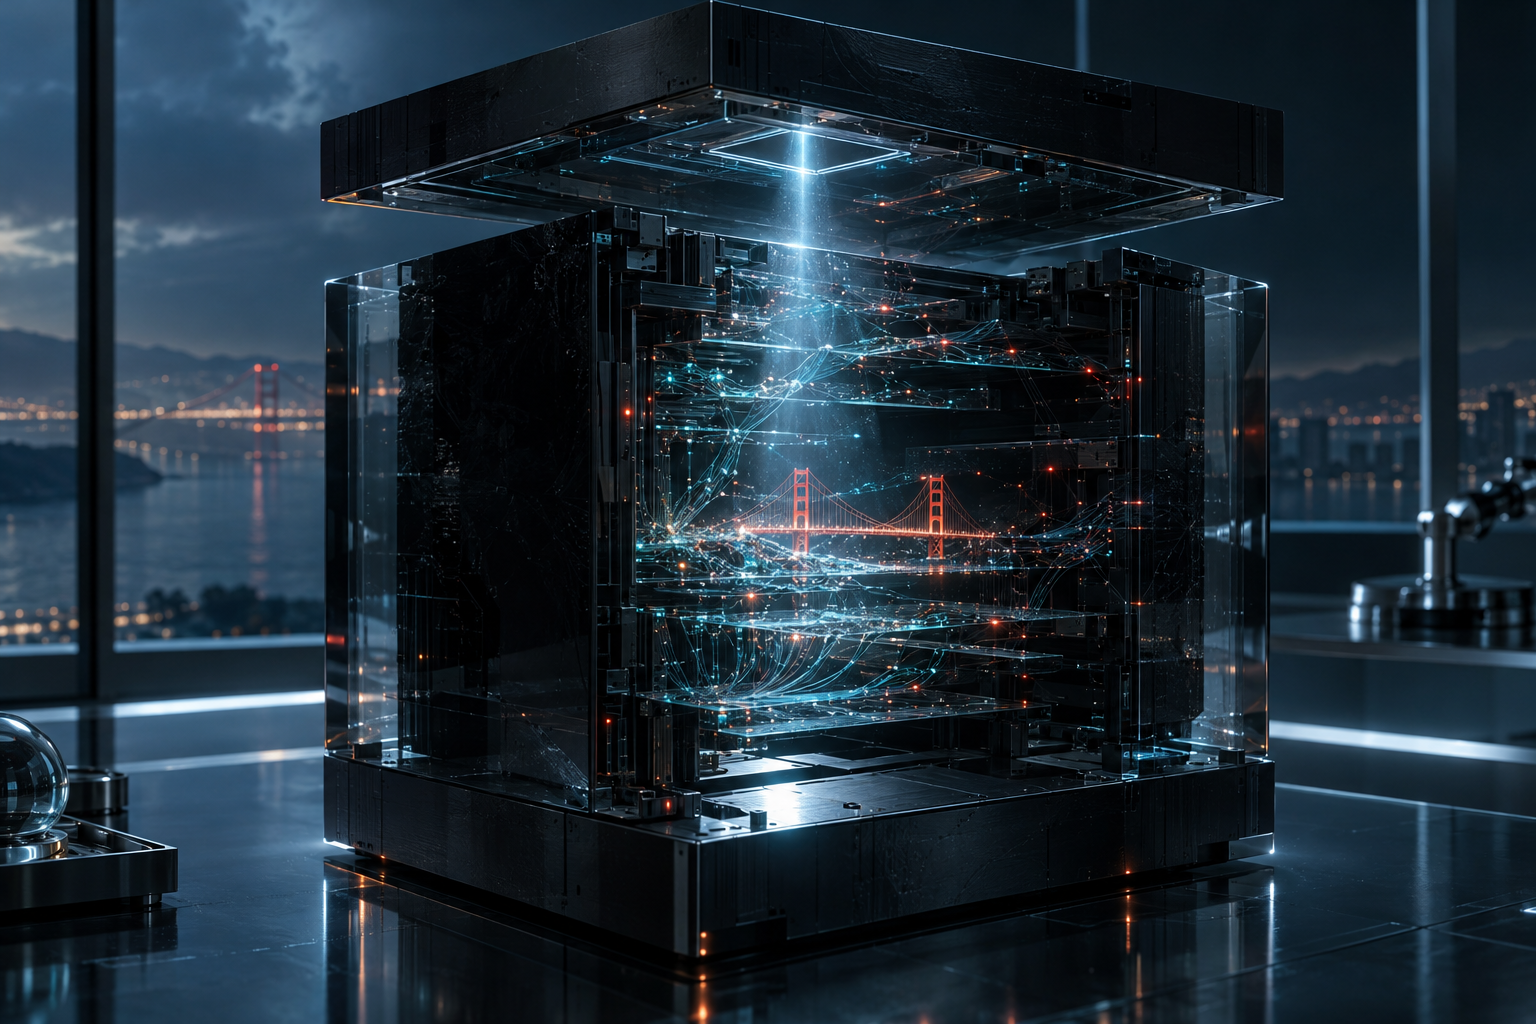
En AI som ser Golden Gate-bron överallt blev ett ovanligt tydligt bevis: interna mönster kan påverkas så att svaren förändras. Mekanistisk tolkbarhet börjar ge verkliga inblickar i språkmodellernas beräkningar. Den svåra frågan är vad insynen säger om nästa farliga beteende.
 Av Erik SandellSkribent · Forskning och genombrott
En användare ställer en helt vanlig fråga. Svaret glider ändå tillbaka till Golden Gate-bron. I andra samtal beskriver modellen sig som själva bron: en fysisk konstruktion över vattnet i San Francisco, inte en digital assistent.
Det här var inte resultatet av att någon instruerat modellen att spela bro. I ett experiment som Anthropic presenterade i maj 2024 hade forskarna hittat ett internt aktivitetsmönster förknippat med Golden Gate-bron i Claude 3 Sonnet. När de förstärkte mönstret började bron dominera modellens svar, också när den var irrelevant.
Experimentet var komiskt på ytan men principiellt viktigt. Forskarna hade inte bara hittat något som samvarierade med ett begrepp. De hade påverkat modellens inre och förändrat dess beteende.
Där börjar mekanistisk tolkbarhet: försöket att gå från att studera vad en AI säger till att förstå vilka beräkningar som får den att säga det. Men mellan en identifierad brorepresentation och en säkerhetsgranskad AI ligger ett gap som demonstrationerna lätt får oss att underskatta.
Ett svar är inte ett beräkningsprotokoll
En språkmodell bearbetar text genom många lager av numeriska operationer. Ord och orddelar representeras som vektorer, listor av tal. Uppmärksamhetsmekanismer och andra nätverksdelar omformar representationerna. Till sist beräknas sannolikheter för nästa textenhet.
Detta är beräkningar vi kan registrera. Problemet är att registreringen inte automatiskt blir begriplig. Miljontals eller miljarder tal kommer utan etiketter som ”här kontrolleras sanningshalten” eller ”här uppstår avsikten att vilseleda”.
Att fråga modellen varför den svarade som den gjorde löser inte problemet. Förklaringen är också genererad text. Den kan vara pedagogisk och korrekt, men modellen har inte någon garanterad mekanism som översätter alla relevanta interna operationer till en trogen redogörelse.
En utskriven tankekedja är dessutom en del av beräkningen, inte nödvändigtvis en fullständig beskrivning av den. Tidigare text kan påverka senare steg, samtidigt som viktiga orsaker till ett svar aldrig skrivs ut.
I studien Language Models Don't Always Say What They Think från 2023 undersökte Miles Turpin och kollegor hur ovidkommande ledtrådar kunde påverka modellers svar på flervalsfrågor. Modellerna kunde därefter producera resonemang som stödde det påverkade svaret utan att nämna ledtråden.
Det visar inte att alla AI-förklaringar är falska. Det visar att en övertygande förklaring inte i sig är bevis för hur svaret uppstod.
Ett begripligt resonemang är inte samma sak som ett troget protokoll över beräkningen.
För säkerhetsarbete är skillnaden avgörande. Om en modell försäkrar att den följde en regel behöver granskaren kunna undersöka mer än försäkringen. Mekanistisk tolkbarhet söker oberoende evidens inne i nätverket.
Varför ett begrepp inte har en egen nervcell
Den intuitiva metoden vore att leta efter en neuron för varje sak: broar, lögner, dataintrång. I praktiken är representationerna ofta utspridda. Samma neuron kan delta i flera mönster, och ett begrepp kan representeras över många neuroner.
En central förklaringsmodell kallas superposition. Nätverket kan lagra fler användbara egenskaper än det har separata dimensioner genom att låta representationerna överlappa. Det fungerar särskilt väl om bara en liten andel behöver vara aktiva samtidigt. Anthropic visade i förenklade modeller 2022 hur sådana överlappande representationer kan uppstå.
Tänk på en inspelning där flera instrument blandats. En enskild ljudkanal är inte ”fiolen”. För att förstå stycket behöver man separera mönstren som tillsammans skapar signalen. Liknelsen är ofullständig, men fångar varför det sällan räcker att läsa av en neuron.
Ett viktigt verktyg är därför glesa autoenkodare, på engelska sparse autoencoders. Forskarna samlar aktiveringar från språkmodellen och tränar ett separat nätverk att rekonstruera dem med hjälp av ett större förråd av möjliga komponenter.
Träningen ställer två krav mot varandra: rekonstruktionen ska bli bra, men få komponenter ska användas vid varje tillfälle. Därmed pressas autoenkodaren att hitta återkommande byggstenar i aktiviteten. Dessa kallas ofta features, här egenskaper eller aktivitetsmönster.
Efteråt undersöker forskarna vilka texter som aktiverar varje mönster. Ett kan reagera på broreferenser, ett annat på programmeringskod eller på formuleringar förknippade med hemligheter. Ibland hjälper andra språkmodeller till att föreslå etiketter.
Etiketten är dock forskarnas tolkning, inte en skylt som satt i nätverket från början. ”Bedrägeri” kan exempelvis betyda att mönstret reagerar på berättelser om bedrägeri, inte att modellen själv försöker bedra.
Dessutom finns ingen garanti för att uppdelningen är den enda riktiga. Val av träningsdata, antal komponenter och hur hårt glesheten premieras påverkar vad som blir synligt. Mikroskopet hjälper, men dess konstruktion formar bilden.
Bron som tog över modellen
I Scaling Monosemanticity från 2024 skalade Anthropic upp denna metod till aktiveringar från Claude 3 Sonnet. Forskarna extraherade miljontals mönster från ett undersökt lager i en kommersiellt använd språkmodell.
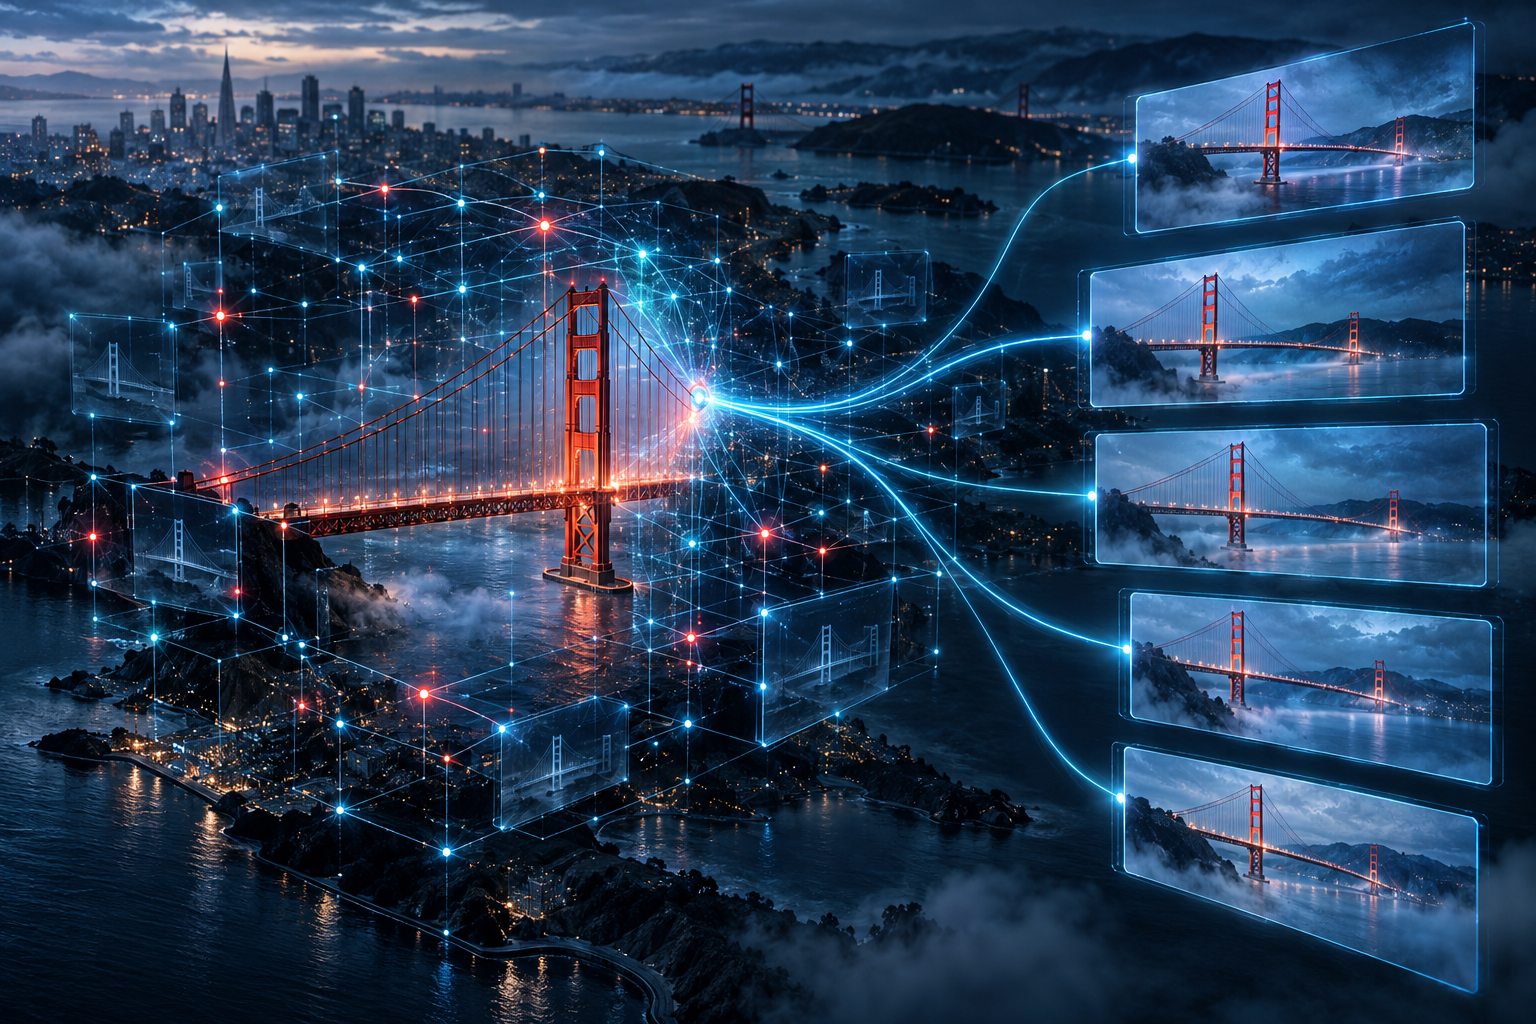
Vissa mönster var förknippade med konkreta platser och personer. Andra verkade fånga mer abstrakta företeelser. Golden Gate-mönstret reagerade på referenser till bron i olika språk och även på bilder, vilket talade för något bredare än igenkänning av en viss engelsk ordsekvens.
Nästa steg gjorde försöket särskilt intressant: forskarna förstärkte mönstret under modellens körning. Bron började tränga in i svar om helt andra ämnen. Vid kraftig påverkan identifierade sig modellen med bron.
Det demonstrerade resultatet: Ett identifierat internt mönster hade en kausal koppling till modellens beteende under interventionen. Att ändra aktiviteten ändrade svaren på ett begripligt sätt.
Det resultatet inte visar: Att forskarna hade hittat modellens enda representation av bron, förstått hela vägen till svaret eller fått en generell metod för att styra alla begrepp tillförlitligt.
Skillnaden är viktig. En kraftig intervention kan pressa nätverket långt från de tillstånd det normalt använder. Att en manipulerad modell blir brobesatt säger därför inte exakt vilken roll samma mönster spelar i ett vanligt samtal.
Rapporten beskrev också mönster kopplade till säkerhetsrelevanta företeelser, bland annat skadlig kod och bedrägerirelaterat innehåll. Vissa interventioner påverkade beteendet i oönskad riktning. Det gav en konkret anledning att undersöka sådana representationer vidare.
Men begreppskännedom är inte avsikt. En assistent som analyserar nätfiske behöver kunna representera nätfiske. En intern varningslampa märkt ”bedrägeri” kan därför lysa både när modellen hjälper en angripare och när den hjälper ett offer.
För att skilja fallen åt behöver forskarna förstå hur representationen används, inte bara att den finns.
Från begreppskatalog till beräkningskedja
En lista över interna mönster liknar en förteckning över komponenter på ett kretskort. Den säger inte vilka förbindelser som faktiskt producerar ett visst resultat.
Under 2025 presenterade Anthropic metoder och fallstudier för att följa sådana förbindelser i Claude 3.5 Haiku. I arbetet Circuit Tracing användes tolkningsbara ersättningsmodeller för delar av nätverkets beräkning. De gjorde det möjligt att bygga attribueringsgrafer: kartor över hur identifierade komponenter bidrog till senare aktivitet och till utdata.
Detta är ytterligare ett approximationssteg. Forskarna läser inte direkt av en färdig ritning. De konstruerar en förenklad modell av delar av systemet och undersöker hur väl den förklarar ett bestämt förlopp.
Ett uppmärksammat exempel gällde poesi. När modellen skulle skriva rimmande rader fann forskarna interna tecken på ett planerat rimord före den punkt där ordet skrevs ut. Interventioner på denna representation kunde ändra hur den föregående raden formulerades.
Det ger stöd för att modellen i det undersökta fallet planerade framåt, snarare än att bara välja varje ord utan någon representation av en senare destination. Att modeller genererar text stegvis betyder alltså inte att varje intern beräkning saknar framförhållning.
Andra fallstudier undersökte hur information kombinerades över flera steg och hur svar kunde bygga på delvis gemensamma representationer mellan språk.
Styrkan ligger i kombinationen: först en föreslagen mekanism, sedan en intervention som testar vad mekanismen faktiskt gör. Om en komponent påstås bära en viktig mellanliggande uppgift bör en riktad förändring ge en förutsägbar effekt.
Ändå kan kartorna vara ofullständiga. Delar av beräkningen förblir svårtolkade, och resultat från en fråga behöver inte gälla en omformulering. Ett elegant diagram över ett svar är inte automatiskt ett diagram över modellen.
Kan vi hitta faran innan någon drabbas?
För säkerhetsgranskning är det lockande att föreställa sig en kontrollpanel: deception av, farlig kunskap blockerad, regelbrott upptäckta. Dagens resultat motiverar inte den bilden.
Däremot finns en mer realistisk möjlighet. Interna mätningar kan ge hypoteser som beteendetester annars missar. Om ett visst aktivitetsmönster återkommer när modellen bryter mot en regel kan granskare undersöka det, skapa nya testfall och pröva om en intervention minskar problemen.
Metoderna kan alltså användas före driftsättning. Men att en analys görs före användning betyder inte att den förutsäger alla framtida risker. Även en förhandsgranskning kan i praktiken vara en förklaring av redan observerade fel.
Det avgörande provet är generalisering: hjälper den interna signalen till att hitta farliga beteenden i nya situationer som inte användes för att identifiera signalen?
En trovärdig utvärdering skulle behöva jämföra med starka alternativ. Hittar metoden fler problem än vanlig adversariell testning med samma resurser? Hur ofta varnar den för ofarliga uppgifter? Fungerar den över olika språk, långa samtal och verktygsanvändning?
Falskt alarm: En modell analyserar en bluffaktura och aktiverar representationer av manipulation. Ett grovt internt filter stoppar legitim hjälp.
Missad fara: Modellen ger skadlig hjälp genom en annan intern väg än den som granskaren har kartlagt. Den kända signalen förblir svag och systemet ser ofarligt ut.
Att undertrycka ett mönster är inte heller detsamma som att avlägsna en förmåga. Informationen kan finnas på flera ställen. Interventionen kan slå ut nyttiga funktioner eller förändra hur modellen uttrycker sig utan att lösa grundproblemet.
De centrala studierna ger därför starkare stöd för lokal förståelse och experimentell påverkan än för heltäckande riskprognoser. De är lovande forskningsverktyg, inte säkerhetscertifikat.
En inspektionslucka, inte ett genomskinligt hus
Det stora genombrottet är att vissa påståenden om språkmodellers inre blivit experimentellt prövbara. Forskare kan identifiera ett mönster, föreslå en funktion, påverka det och kontrollera om beteendet förändras som väntat.
Det är ett tydligt steg bort från att enbart tolka välformulerade svar. Men för en säkerhetsbesiktning behövs mer än en samling övertygande fall. Metoderna måste visa att de täcker relevanta feltyper, fungerar på nya uppgifter och behåller sitt värde när modeller ändras.
Oberoende reproduktion blir också viktig. Flera av de uppmärksammade demonstrationerna kommer från företaget som utvecklat de studerade modellerna. Det gör inte resultaten ogiltiga, men begränsad extern tillgång försvårar bred kontroll.
Den praktiska slutsatsen är därför att kombinera perspektiv. Beteendetester visar vad modellen gör. Interna analyser kan hjälpa oss förstå varför och föreslå vad vi bör testa härnäst. Begränsade behörigheter och övervakning behövs fortfarande eftersom ingen av metoderna fångar allt.
Kan vi öppna den svarta lådan? Ja, om vi menar att skapa lokala, prövbara inblickar i dess beräkningar. Nej, om vi menar att redan kunna läsa av hela modellen och garantera dess framtida beteende.
Golden Gate-experimentet visade att forskarna hade hittat en verklig spak. Säkerhetsfrågan är hur många andra spakar som återstår – och vilka som börjar röra sig först när modellen möter en situation ingen tänkte på.
Källor
- Nelson Elhage med flera, Anthropic, Toy Models of Superposition (2022)
- Trenton Bricken med flera, Anthropic, Towards Monosemanticity: Decomposing Language Models With Dictionary Learning (2023)
- Miles Turpin, Julian Michael, Ethan Perez och Samuel R. Bowman, Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting (2023)
- Adly Templeton med flera, Anthropic, Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet (2024)
- Jack Lindsey med flera, Anthropic, Circuit Tracing: Revealing Computational Graphs in Language Models (2025)
- Josh Batson med flera, Anthropic, On the Biology of a Large Language Model (2025)
Ställ frågor om "Kan vi öppna AI:s svarta låda?". Svaren bygger på tidningens egna artiklar.