När AI hittar på – och hur du avslöjar det
Den säkra tonen är ingen sanningsgaranti. Så bygger du ett arbetsflöde där svaren går att kontrollera.
En språkmodell kan formulera ett övertygande svar utan att uppgifterna stämmer. Lösningen är inte en magisk prompt, utan en kombination av avgränsade frågor, spårbara källor och oberoende kontroller. Här är mekaniken bakom hallucinationerna – och en praktisk metod för att fånga dem.
 Av Erik SandellSkribent · Forskning och genombrott
Ett rättsfall som aldrig funnits
I det amerikanska målet Mata v. Avianca 2023 fick en domstol ta emot en juridisk inlaga med hänvisningar till rättsfall som inte existerade. Juristen som använt ChatGPT hade fått trovärdigt formulerade uppgifter om tidigare avgöranden. När han frågade om rättsfallen var verkliga gav tjänsten ytterligare försäkringar. De var ändå påhittade. Domstolen beslutade senare om sanktioner mot de ansvariga juristerna och deras byrå.
Det obehagliga är inte att texten såg konstig ut. Det är att den såg användbar ut: namn, juridiska resonemang och referenser i rätt stil. Formen signalerade efterforskning, men innehållet saknade verklighetsförankring.
Detta är en AI-hallucination: ett genererat påstående som är felaktigt eller saknar stöd, presenterat som om det vore tillförlitligt. Begreppet omfattar flera problem. En modell kan uppfinna en källa, ange fel årtal eller tillskriva en riktig rapport en slutsats som inte finns där. Den kan också förvränga dokumentet användaren nyss laddade upp.
Allt som är fel i ett AI-svar är dock inte samma sorts fel. En söktjänst kan hitta en gammal uppgift. En databas kan innehålla ett misstag. En modell kan misstolka en fråga. För användaren blir slutresultatet fel ändå, men rätt motåtgärd beror på var felet uppstod.
Den viktigaste utgångspunkten är därför enkel:
Ett välformulerat svar är ett förslag att granska, inte ett bevis på att granskningen redan är gjord.
Varför modellen fyller i luckorna
En generativ språkmodell tränas först på att förutsäga nästa textenhet, en så kallad token, utifrån föregående text. Genom enorma mängder exempel lär den sig grammatik, samband, faktamönster och mycket som liknar resonemangsstrategier. Efterträning styr sedan modellen mot exempelvis hjälpsamma svar och bättre följsamhet till instruktioner.
Men grundträningen är inte en faktadatabas där varje mening har en kontrollerad källpost. Informationen finns utspridd i modellens numeriska parametrar. När modellen svarar återskapar den inte nödvändigtvis ett känt dokument; den genererar en fortsättning som passar sammanhanget.
Det förklarar hur en påhittad forskningsreferens kan bli så övertygande. Modellen har lärt sig hur författarnamn, tidskriftstitlar och artikelrubriker brukar kombineras. Om den saknar ett tillräckligt starkt samband till en verklig publikation kan den ändå producera en bibliografiskt elegant konstruktion.
Problemet är inte bara kunskapsluckor. Träningsmaterial kan innehålla motsägelser, föråldrade uppgifter och sakfel. Frågan kan dessutom innehålla ett falskt antagande: ”Varför förbjöd Sverige den här tekniken 2022?” En följsam modell kan börja förklara förbudet i stället för att kontrollera om det inträffade.
Även information som faktiskt finns i underlaget kan missas. Studien Lost in the Middle visade att språkmodellers användning av relevant information kunde försämras när den placerades mitt i långa inmatningar. Resultatet gäller de testade modellerna och uppgifterna, inte varje framtida system, men illustrerar en viktig skillnad: att kunna ta emot många sidor är inte samma sak som att tillförlitligt använda varje sida.
Säkerheten i formuleringen hjälper inte heller särskilt mycket. Sannolikheten för en språklig fortsättning är inte samma sak som sannolikheten att påståendet är sant. Ett svar kan låta självsäkert därför att självsäkra svar passar textmönstret.
Att be modellen ange sin säkerhet i procent löser inte detta. Utan särskild utvärdering av hur väl sådana bedömningar stämmer är siffran också genererad text. ”Jag är 95 procent säker” är ingen kalibrerad mätning bara för att den innehåller ett tal.
Källor och verktyg hjälper – men kedjan kan brista
En viktig teknik mot hallucinationer är retrieval-augmented generation, RAG. Principen är att systemet först söker fram relevanta dokument och sedan låter språkmodellen formulera svaret med dessa dokument som underlag. Lewis och medförfattare beskrev en inflytelserik sådan arkitektur 2020.
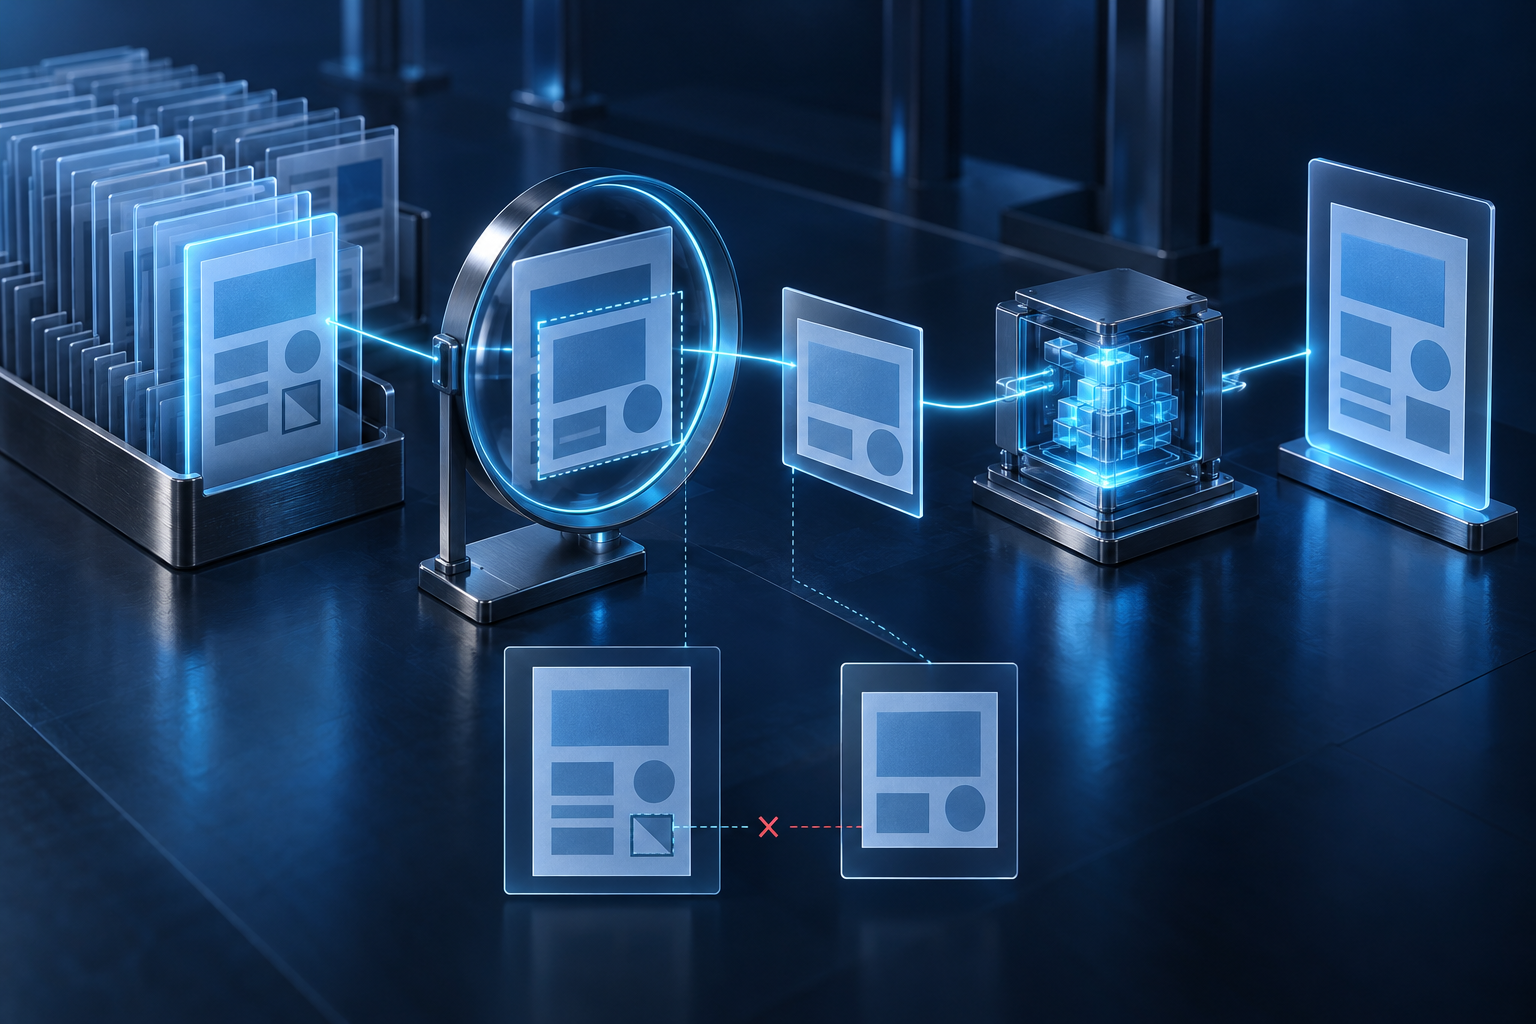
I en kundtjänst kan det innebära att frågan om en returrätt kopplas till företagets aktuella villkor. I stället för att förlita sig på vad modellen lärde sig under träningen får den läsa rätt text vid svarstillfället. Underlaget kan uppdateras utan att hela modellen tränas om.
Det är ett betydelsefullt framsteg, men ingen sanningsmaskin. Sökningen kan hämta fel dokument. Rätt dokument kan vara inaktuellt. Ett utdrag kan sakna det avgörande undantaget. Slutligen kan modellen dra en slutsats som underlaget inte stödjer.
Därför måste tre saker hållas isär: källan finns, källan är relevant och källan stödjer just påståendet. En riktig länk klarar bara den första kontrollen.
Samma sak gäller verktyg med källhänvisningar. Välj gärna en tjänst med webbsökning eller dokumentförankring där hänvisningarna går att öppna. För egna dokument är sidnummer, avsnitt och synliga textutdrag särskilt användbara. Men kontrollera att hänvisningen gäller den konkreta meningen, inte bara ämnet i stort.
Beräkningsverktyg fyller en annan funktion. En kalkylator kan räkna korrekt på tal som modellen annars hade hanterat fel. Den kan däremot inte avgöra om modellen valt rätt tal, valuta eller tidsperiod. Verktygets precision räddar inte en felställd uppgift.
Forskningen försöker också upptäcka osäkra svar automatiskt. I en Nature-studie 2024 undersökte Farquhar och kollegor semantisk entropi: hur mycket innebörden varierar mellan flera genererade svar. Om samma fråga ger oförenliga besked är det en varningssignal. Men en modell som konsekvent upprepar samma fel kan fortfarande undgå en sådan kontroll. Metoden är en osäkerhetsindikator, inte en universell lögndetektor.
Skriv prompten som en granskningsinstruktion
Promptteknik kan minska vissa risker, framför allt genom att begränsa uppgiften och göra brister synliga. Den kan inte garantera sanningen. Instruktionen ”hallucinera inte” tillför varken kunskap eller verifiering.
Börja i stället med att ange vad svaret får bygga på. Om du granskar ett avtal, skriv att endast det bifogade avtalet ska användas. Om du behöver aktuella regler, ange land och datum och kräv kontroll mot ansvarig myndighet.
En användbar grundprompt är:
Besvara frågan enbart utifrån de bifogade dokumenten. Ange dokumentnamn och avsnitt för varje centralt sakpåstående. Skilj mellan uttryckliga uppgifter och dina slutsatser. Om underlaget inte räcker, skriv vad som saknas. Uppfinn inte hänvisningar. Kontrollera också om frågans antaganden stöds av materialet.
För en tjänst med webbsökning kan du lägga till: ”Sök i första hand primärkällor. Ange publiceringsdatum eller uppdateringsdatum när det framgår. Markera om du inte kan öppna originalkällan.” Utan sökverktyg bör du inte behandla en lista med föreslagna länkar som verifierade sökresultat.
Dela sedan upp arbetet. Be först om relevanta källavsnitt, därefter om en sammanfattning och sist om en granskning av vilka slutsatser som saknar direkt stöd. Det gör fel lättare att lokalisera än om allt bakas ihop i en polerad sluttext.
Be gärna om korta, ordagranna utdrag som belägg, men jämför dem med originalet. Även citat kan vara felgenererade. Ett långt redovisat resonemang är inte heller någon garanti; viktigare är att de avgörande stegen går att kontrollera utanför modellen.
Till sist: ge modellen en tydlig möjlighet att avstå. ”Svara hellre att underlaget saknas än att fylla i luckor” är en bättre arbetsregel än ”ge alltid ett komplett svar”. Komplettera med vad den ska göra vid osäkerhet: ställa en följdfråga, söka vidare eller lämna punkten obesvarad.
Kontrollera arbetet i sju steg
Anta att du ber en AI sammanfatta garantivillkor inför ett inköp. Svaret säger att garantin gäller i tre år och omfattar batteriet. Så här granskar du resultatet, utan att behöva vara expert på språkmodeller.
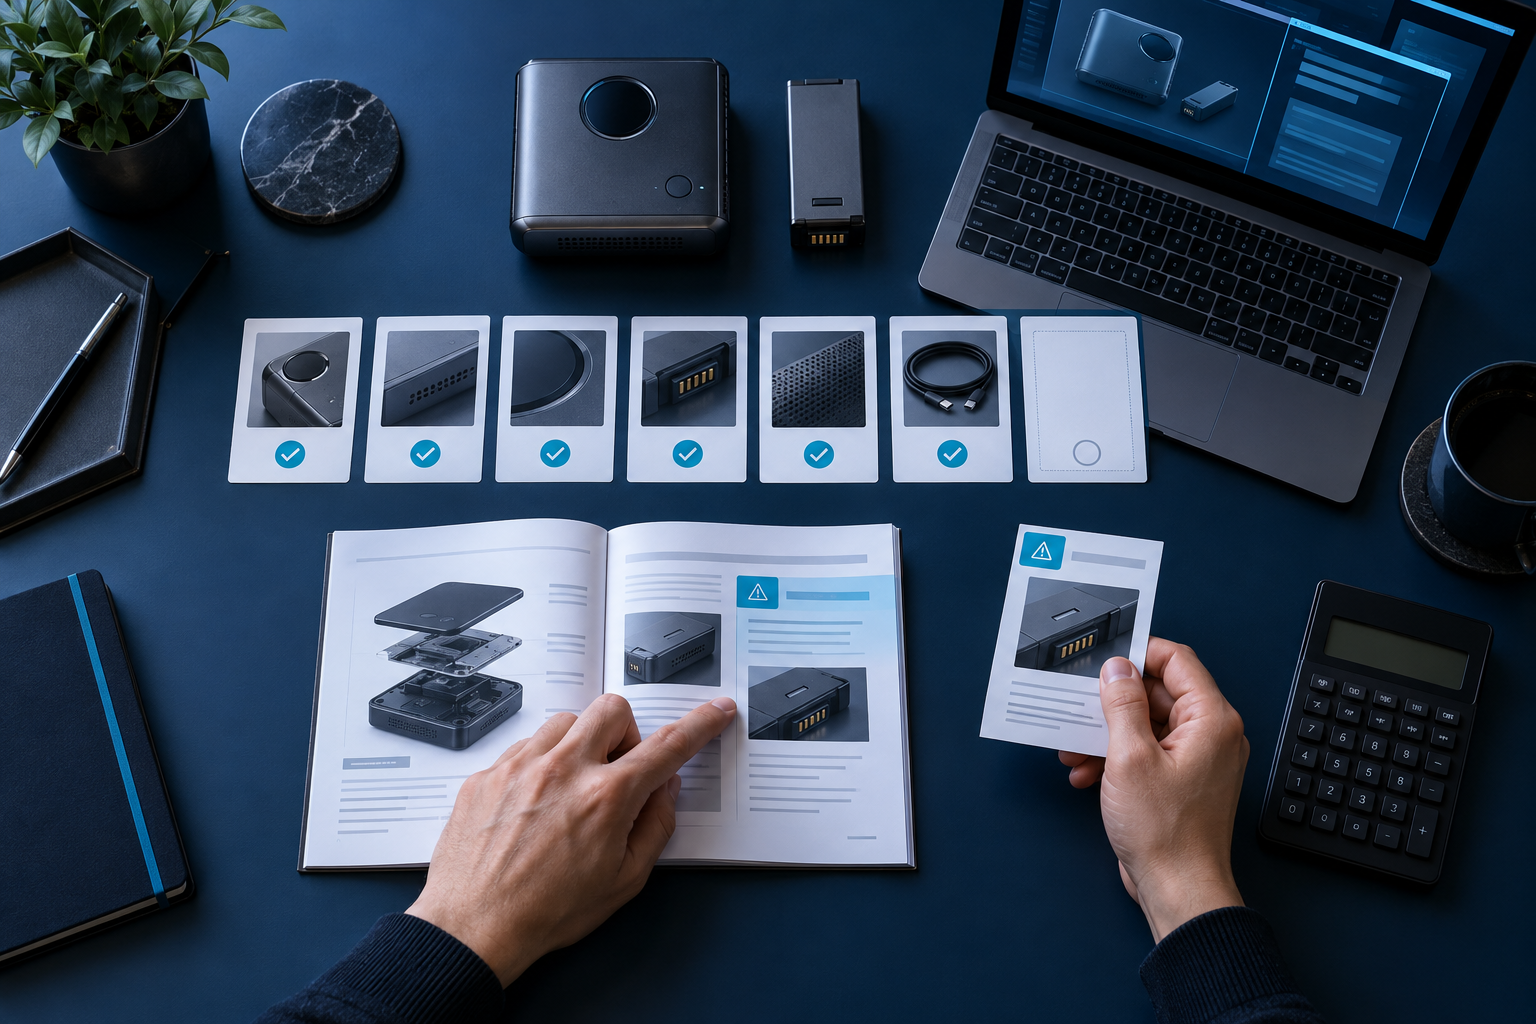
1. Bestäm konsekvensen av ett fel. Ska texten hjälpa dig att orientera dig, eller avgöra ett köp för stora belopp? Ju större ekonomisk, medicinsk eller juridisk betydelse, desto mindre bör du acceptera okontrollerade uppgifter. Vid höga risker behövs ofta relevant expertis, inte bara fler AI-frågor.
2. Bryt ut påståendena. Skriv en kort lista: tre års garanti, batteriet ingår, villkoren gäller i Sverige, modellen omfattas. En enda mening kan innehålla flera kontrollerbara uppgifter. Be gärna AI:n göra listan, men kontrollera att den inte utelämnar något avgörande.
3. Öppna originalkällorna. Gå till tillverkarens villkor, inte enbart sökresultatets sammanfattning eller en återförsäljares blogg. Kontrollera dokumentets datum, produktversion och geografiska giltighet. En gammal manual kan vara äkta men ändå fel underlag för dagens köp.
4. Matcha varje påstående mot belägget. Finns treårsperioden uttryckligen angiven? Gäller den hela produkten? Står batteriet i ett undantagsavsnitt? Läs före och efter det citerade stycket. Markera varje uppgift som styrkt, motsagd eller ännu inte verifierad. Det sista är inte samma sak som falsk.
5. Kontrollera siffror och definitioner separat. Räkna om summor med kalkylator eller kalkylblad. Kontrollera enheter, nämnare, moms och tidsperioder. I garantiexemplet måste du också skilja mellan garanti och lagstadgade rättigheter; ord som låter närliggande kan ha olika innebörd.
6. Sök efter motbevis. Leta uttryckligen efter undantag, senare ändringar och alternativa tolkningar. För omstridda sakuppgifter kan en oberoende källa behövas. Två sajter som återger samma pressmeddelande är inte två oberoende belägg.
7. Dokumentera det som återstår. Spara länkar, relevanta utdrag och granskningsdatum. Om batterivillkoret fortfarande är oklart, skriv det i slutsatsen och fråga leverantören. En synlig lucka är bättre beslutsunderlag än ett osynligt antagande.
Den här processen tar tid, men behöver inte tillämpas lika tungt på varje mening. Lägg mest arbete på de uppgifter som beslutet faktiskt hänger på. Låt AI:n hjälpa till att organisera kontrollen, inte ensam godkänna sitt eget resultat.
Det avgörande testet sker utanför chatten
Det finns ingen språklig detalj som säkert avslöjar en hallucination. Stavfel bevisar inte att en uppgift är falsk, och elegant prosa bevisar inte att den är riktig. Att fråga samma modell ”är du säker?” kan ibland leda till en rättelse, men ibland bara till ännu en övertygande försäkran.
En andra modell kan fungera som kritisk läsare. Den kan upptäcka motsägelser och föreslå kontroller. Men modeller kan dela kunskapsluckor och återge samma spridda fel. Överensstämmelse mellan två chattbotar ersätter inte ett originaldokument, en mätning eller en korrekt genomförd beräkning.
För organisationer blir nästa steg att mäta kvalitet på representativa arbetsuppgifter. Testa systemet mot dokumenterade facit, inkludera frågor där underlaget saknar svar och följ både felaktiga besked och onödiga avståenden. Ett system som aldrig svarar hallucinerar mindre, men gör heller ingen nytta. Målet är användbara svar med en rimlig och synlig gräns för vad systemet kan belägga.
Snabbcheck före användning:
- Är frågan avgränsad till rätt tid, plats och version?
- Har modellen faktiskt tillgång till nödvändiga källor?
- Går varje avgörande uppgift att spåra till ett original?
- Stödjer källan formuleringen, inklusive eventuella undantag?
- Är siffror och beräkningar kontrollerade separat?
- Är osäkerheter synliga, och kräver beslutet en expert?
Den praktiska skiljelinjen går alltså inte mellan texter som låter sanna och texter som låter falska. Den går mellan påståenden som har kontrollerats och påståenden som ännu inte har det. AI blir betydligt mer användbar när den skillnaden får styra arbetet.
Källor
- United States District Court for the Southern District of New York, P. Kevin Castel, Mata v. Avianca, Inc., 678 F. Supp. 3d 443 (2023)
- OpenAI, GPT-4 Technical Report (2023)
- Patrick Lewis med flera, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- Nelson F. Liu med flera, Lost in the Middle: How Language Models Use Long Contexts (2024)
- Sebastian Farquhar, Jannik Kossen, Lorenz Kuhn och Yarin Gal, Detecting hallucinations in large language models using semantic entropy (2024)
- National Institute of Standards and Technology, Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (2024)
Ställ frågor om "När AI hittar på – och hur du avslöjar det". Svaren bygger på tidningens egna artiklar.