Vem får jobbet när AI sorterar bort ditt CV?
En ansökan kan bedömas långt innan en människa läser den. Men vem kan förklara varför du hamnade längst ned?
AI lovar snabbare och mer träffsäker rekrytering. För den arbetssökande kan resultatet bli en osynlig rangordning där erfarenhet översätts till poäng och gamla orättvisor får teknisk kostym. Vi följer en fiktiv ansökan genom urvalet – och granskar vad EU:s regler faktiskt kan förändra.
 Av Leyla DemirSkribent · Arbetsliv och automation
Uppläst av tidningens berättarröst
Samira har arbetat med kundservice i åtta år. Hon har introducerat nya kollegor, hanterat reklamationer och hållit ihop arbetspass när chefen varit borta. Nu söker hon en tjänst som teamledare. I annonsen står det att arbetsgivaren värdesätter ledarskap, problemlösning och erfarenhet av digitala kundsystem.
Hon laddar upp sitt CV. Sedan får hon skriva in delar av samma information igen: anställningar, utbildning, kompetenser. En ruta berättar att företaget använder digitala verktyg i rekryteringen. Ett dygn senare kommer avslaget.
”Vi har valt att gå vidare med andra kandidater vars profil bättre matchar tjänsten.”
Samira vill veta vad som saknades. Var det en utbildning? Att hennes titel aldrig varit teamledare? Ett avbrott mellan två anställningar? Eller fanns det helt enkelt sökande med mer relevant erfarenhet?
Samira och hennes ansökan är fiktiva. Även arbetsgivarens svar längre fram är konstruerade för att pröva hur olika förklaringar fungerar. Urvalsstegen bygger däremot på dokumenterade typer av rekryteringsteknik. Det är viktigt att hålla isär: vi vet inte att ett visst system skulle bedöma just hennes meriter på det sätt som beskrivs.
Det verkliga problemet är att den sökande ofta inte vet vilket slags bedömning som över huvud taget har gjorts. Samma vänliga avslagsmejl kan avsluta en mänsklig helhetsbedömning, ett enkelt behörighetsfilter eller en statistisk rangordning av tusentals människor.
1. Första grinden är inte alltid AI
Samiras ansökan landar i ett rekryteringssystem, ofta kallat ATS, applicant tracking system. Det är i grunden en miljö för att ta emot ansökningar, organisera kandidater och dokumentera rekryteringen. Att en arbetsgivare använder ett sådant system betyder inte i sig att AI bedömer vem som ska få jobbet.
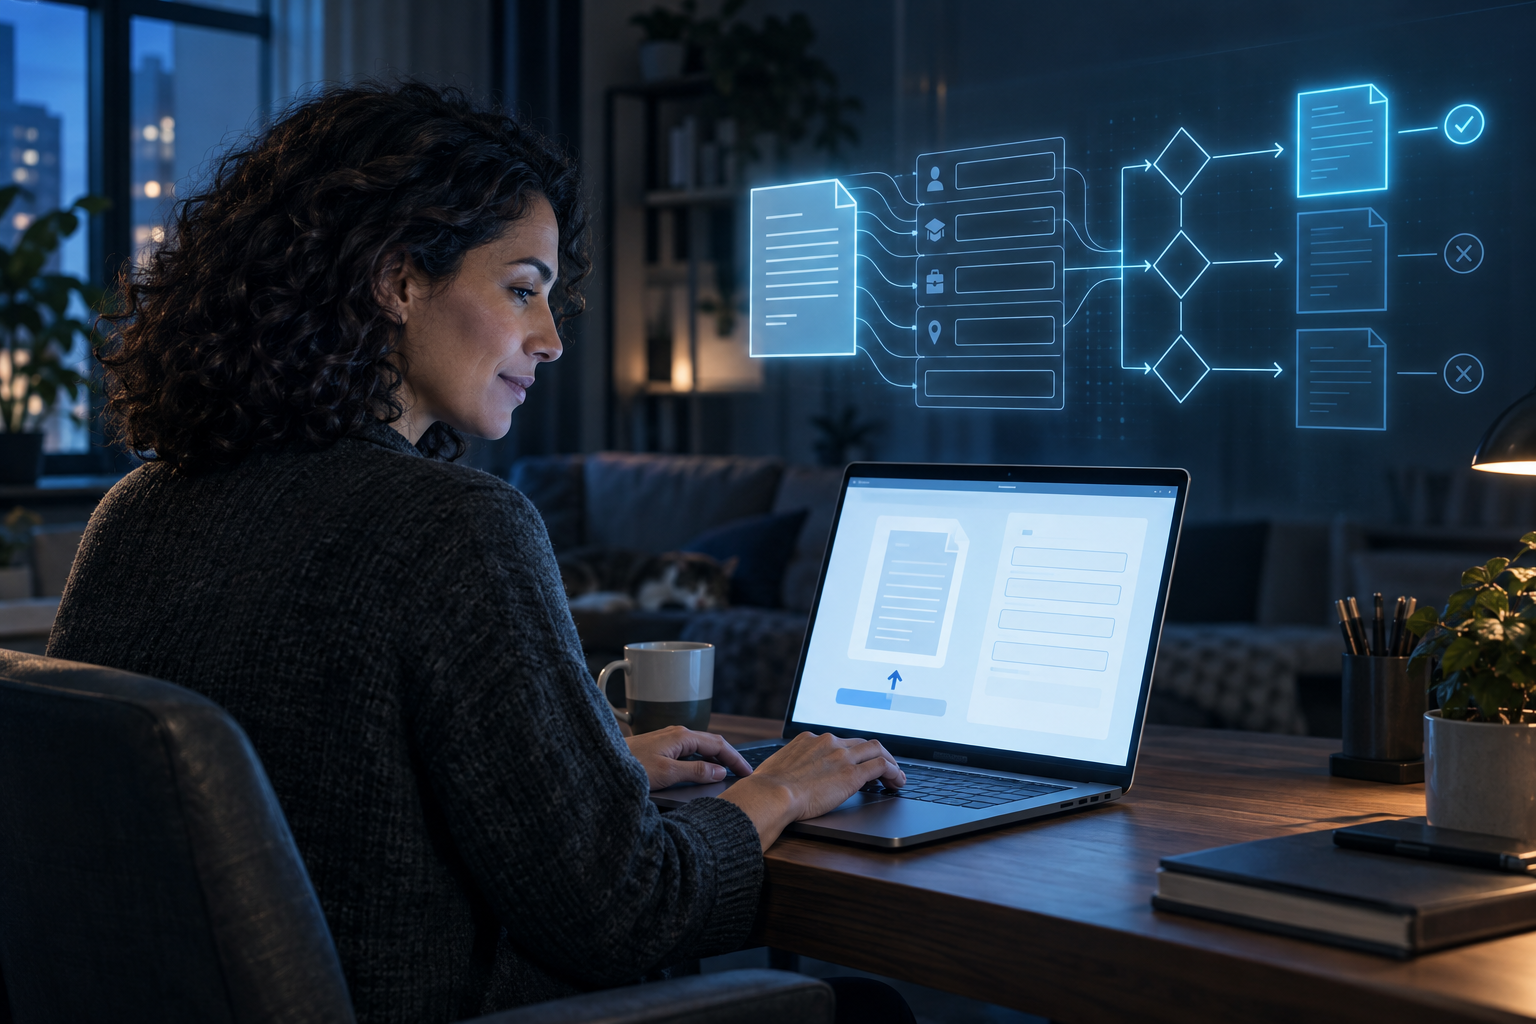
Ett vanligt urval kan bygga på fasta regler. Har kandidaten det körkort som tjänsten kräver? Finns en viss legitimation? Har personen svarat ja på en fråga om arbetstider? Systemet kan också söka efter ord eller låta rekryteraren filtrera på registrerade uppgifter. Ett enkelt filter som arbetsgivaren har definierat är inte automatiskt ett AI-system i AI-förordningens mening.
Det gör inte filtret oskyldigt. Om arbetsgivaren kräver en examen som egentligen inte behövs för arbetet kan människor stängas ute i onödan. Om en fråga är otydlig kan ett korrekt svar leda fel. Diskrimineringsrätt och dataskydd kan vara relevanta även när tekniken är betydligt enklare än en språkmodell.
Nästa steg kan vara maskinell texttolkning. Ett program försöker hitta yrkestitlar, datum och kompetenser i dokumentet och lägga dem i strukturerade fält. Även här varierar tekniken. Vissa verktyg använder regler, andra maskininlärning eller språkmodeller.
För Samira är skillnaden konkret. Hon har skrivit ”ansvarade för introduktion av nyanställda”. Ett sökordsfilter efter ”personalansvar” kanske inte hittar detta. Ett system som tolkar betydelsen kan förstå att erfarenheten är relevant för ledarskap. Men det kan också dra för långtgående slutsatser: att introducera kollegor är inte samma sak som att ha haft arbetsmiljöansvar eller genomfört lönesamtal.
Här uppstår ansökans första översättning. En berättelse om arbete blir databaspunkter. Om den översättningen blir fel kan alla senare steg se konsekventa ut och ändå bygga på en missuppfattning.
Den första insynsfrågan borde därför vara enklare än ”vilken algoritm använder ni?”: Vilka uppgifter om mig har systemet faktiskt registrerat? Har min erfarenhet hamnat i rätt fält? Går en felaktigt avläst anställningstid att rätta innan urvalet är färdigt?
Ett företag som inte kan svara på detta har ett problem redan innan någon avancerad AI börjar rangordna kandidaterna.
2. När erfarenhet blir en matchningspoäng
I nästa tänkbara steg jämför ett AI-system Samiras profil med jobbannonsen. Det kan använda så kallade embeddings: numeriska representationer där texter med liknande betydelse placeras nära varandra. Då kan ”hanterat missnöjda kunder” matcha ”konflikthantering” även om formuleringarna skiljer sig.
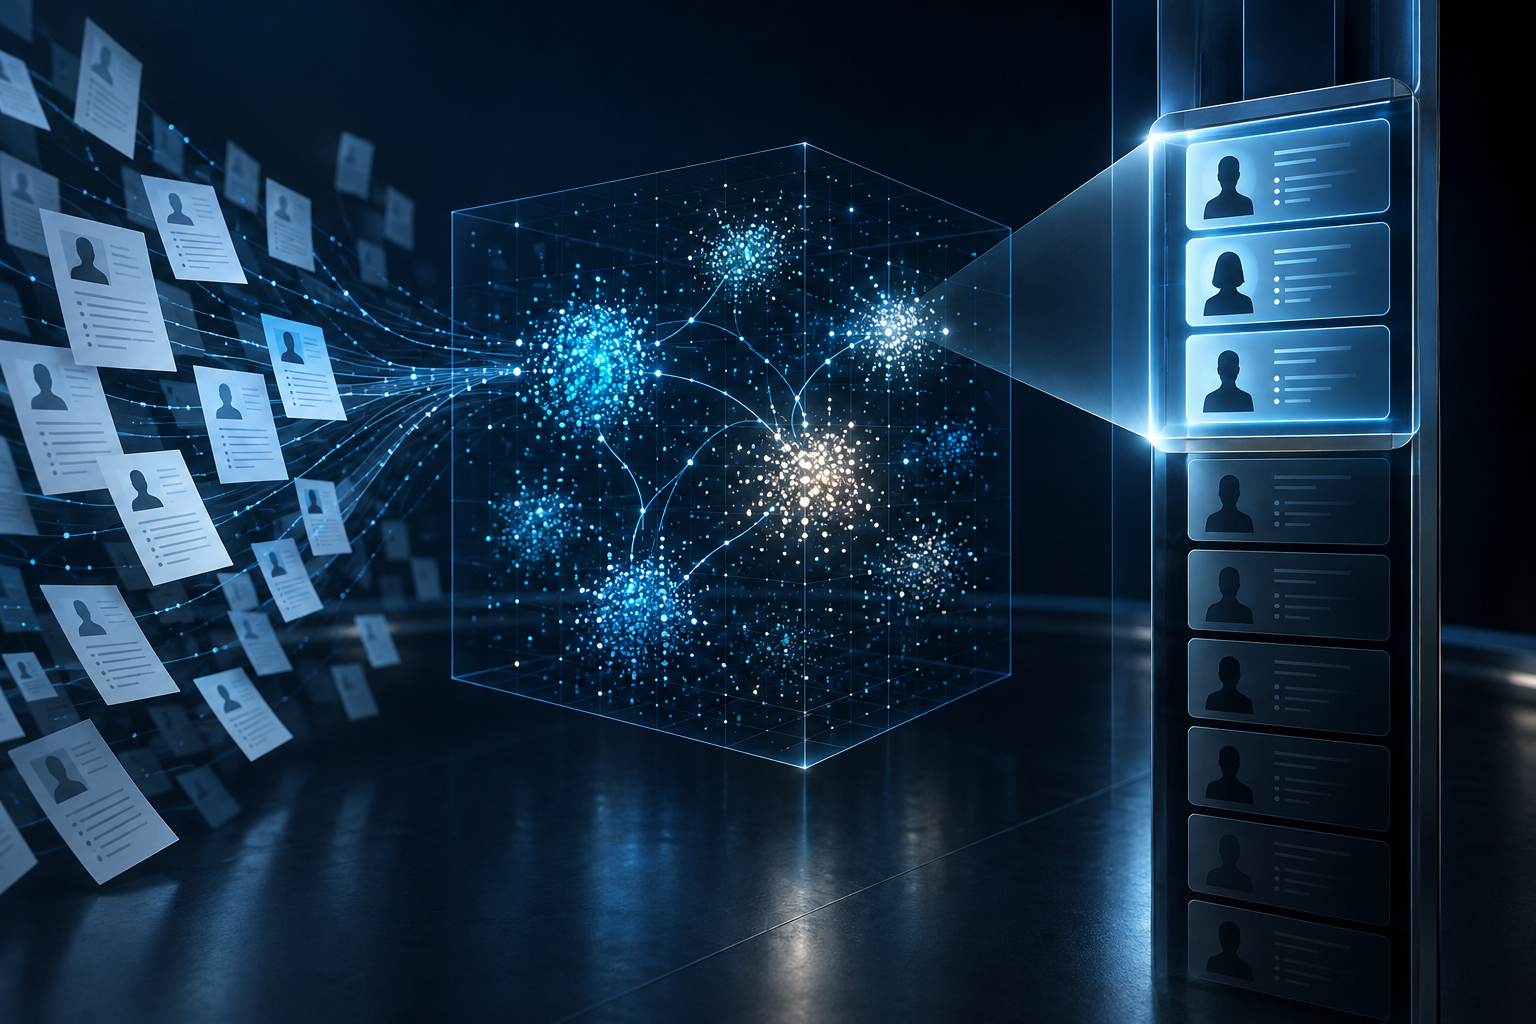
Andra system använder modeller tränade för att förutsäga ett visst utfall. Det kan vara vilka kandidater rekryterare tidigare valt att intervjua, vilka som anställts eller vilka som fått höga prestationsbetyg. En språkmodell kan också få instruktionen att sammanfatta ett CV och bedöma det mot en kravlista. Produkter kan kombinera flera av dessa metoder.
De gör inte samma sak. Textlikhet mäter inte automatiskt yrkesskicklighet. Att efterlikna tidigare rekryterares beslut är inte detsamma som att hitta dem som skulle göra arbetet bäst. Och en välskriven motivering från en språkmodell bevisar inte att bedömningen är korrekt eller stabil.
Anta, som illustration, att Samira får matchningspoängen 68. Siffran säger nästan ingenting utan sammanhang. Är den ett internt jämförelsetal, en sammanvägning av kriterier eller en kalibrerad sannolikhet för ett tydligt definierat utfall? Den får inte utan belägg läsas som att hon har 68 procents chans att lyckas i arbetet.
Det avgörande kan i stället vara hur arbetsgivaren använder siffran. Om rekryteraren bara öppnar de tjugo högst rankade ansökningarna fungerar rangordningen som en grind, även om ingen knapp heter ”automatiskt avslag”. Kandidater längre ned kan i praktiken vara bortvalda innan en människa granskat deras erfarenheter.
Samtidigt finns en verklig möjlighet till förbättring. Ett väl utformat verktyg kan hitta relevanta meriter bakom ovanliga yrkestitlar, upptäcka erfarenhet från andra branscher och göra ett första urval mer konsekvent. Samira skulle kunna gynnas av att hennes praktiska ledarskap blir synligt trots att hon saknar rätt titel.
Men konsekvens är inte samma sak som rättvisa. Ett system kan tillämpa ett dåligt kriterium mycket konsekvent.
Arbetsgivaren behöver därför kunna beskriva vilket problem modellen ska lösa, vilket resultat den har testats mot och varför det resultatet är relevant för just tjänsten. ”Vi använder datadriven rekrytering” är en beskrivning av en ambition, inte ett belägg för kvalitet.
3. Historien följer med in i modellen
Det mest omtalade exemplet kommer från Amazon. Reuters rapporterade 2018 att företaget hade utvecklat ett experimentellt rekryteringsverktyg som lärde sig av tidigare ansökningar. Materialet speglade en mansdominerad teknikbransch. Enligt granskningen missgynnade systemet bland annat CV:n med ordet ”women’s”, som i beskrivningar av kvinnoföreningar.
Amazon övergav projektet. Reuters rapporterade också att rekryterare hade tittat på rekommendationerna, men inte förlitat sig enbart på dem. Det är alltså inte belägg för att ett sådant system ensamt avgjorde företagets anställningar. Däremot visar fallet en central mekanism: historiska data innehåller både erfarenhet och historiska urvalsmönster.
Om en arbetsplats främst har befordrat en viss sorts personer kan modellen lära sig kännetecknen för dem som fått möjligheten, snarare än egenskaperna hos alla som skulle ha klarat jobbet. Prestationsbetyg löser inte automatiskt problemet. Även de kan påverkas av vilka arbetsuppgifter någon fått, chefers bedömningar och tillgång till stöd.
Att ta bort namn, kön och ålder är därför inte en universallösning. Andra uppgifter kan fungera som indirekta markörer: utbildningsvägar, vissa föreningsmeriter eller arbetslivets tidsmönster. Det betyder inte att varje sådan uppgift måste förbjudas. Det betyder att arbetsgivaren behöver undersöka vad modellen faktiskt använder och vilka följder det får.
I Samiras fall skulle ett system exempelvis kunna behandla en period utan anställning som en negativ signal. Men uppehållet säger i sig inte om hon kan leda ett kundserviceteam. Det kan ha handlat om omsorg, sjukdom, studier eller en svag arbetsmarknad. Att fylla luckan med en statistisk misstanke är inte samma sak som att bedöma en arbetsrelevant kompetens.
Alla skadliga urval kräver heller ingen lärande AI. I det amerikanska iTutorGroup-fallet uppgav diskrimineringsmyndigheten EEOC att företagets ansökningsprogram automatiskt avvisade kvinnliga sökande från 55 års ålder och manliga från 60. Företagen gick 2023 med på en förlikning på 365 000 dollar. Det illustrerar risken med automatiserade regler, inte i sig hur maskininlärning fungerar.
Forskningen ger också skäl att syna leverantörernas löften. I studien Mitigating Bias in Algorithmic Hiring: Evaluating Claims and Practices undersökte forskare hur leverantörer beskrev validering och arbete mot diskriminering. En viktig lärdom är att ord som ”rättvis” och ”validerad” måste packas upp: testat mot vad, för vilka människor och i vilken användning?
4. Samira begär en förklaring
Samira skriver till arbetsgivaren: ”Användes automatiserat beslutsfattande? Vilka uppgifter och kriterier gjorde att jag inte gick vidare? Kan en person granska min ansökan?”
Det är tre olika frågor. De kan också aktivera olika rättigheter.
GDPR gäller redan för behandling av personuppgifter i rekrytering. Den sökande kan bland annat begära tillgång till sina personuppgifter och rättelse av felaktiga uppgifter. Rätten till tillgång är inte en obegränsad rätt att få hela företagets programvara eller andra kandidaters uppgifter, men kan vara viktig för att upptäcka fel i den egna profilen.
Artikel 22 gäller en särskild situation: beslut som grundas enbart på automatiserad behandling och har rättsliga följder eller på liknande sätt påverkar personen betydande. Huvudregeln är att individen har rätt att inte bli föremål för sådana beslut. Det finns undantag, bland annat under vissa förutsättningar för avtal och uttryckligt samtycke, men de är inte en allmän frisedel för automatisk rekrytering.
Vid de avtals- och samtyckesundantag som artikeln anger ska skyddsåtgärder åtminstone innefatta möjlighet till mänskligt ingripande, att framföra sin ståndpunkt och att bestrida beslutet. Samtycke i en beroendesituation måste dessutom bedömas omsorgsfullt; en kryssruta gör inte automatiskt behandlingen laglig.
Att någon formellt trycker på ”godkänn” räcker inte nödvändigtvis för att beslutet ska betraktas som mänskligt. Granskningen måste vara verklig. Personen behöver förstå underlaget, kunna bedöma det självständigt och ha befogenhet att ändra utfallet. Exakt hur artikel 22 träffar ett arbetsflöde beror på omständigheterna.
GDPR innehåller också informationskrav om sådant automatiserat beslutsfattande, inklusive meningsfull information om logiken samt betydelsen och de förutsedda följderna. Detta ska inte blandas ihop med en ovillkorlig rätt till en individuell förklaring av varje AI-assisterat avslag.
Ett svagt, fiktivt svar till Samira vore: ”Systemet gör en objektiv helhetsbedömning.” Ett bättre svar vore: ”Vi registrerade ingen erfarenhet av arbetsledning. Det kriteriet användes i urvalet. Vi ser nu att ditt CV beskriver introduktion och samordning och låter en rekryterare bedöma den erfarenheten.”
Det senare lovar inte en intervju. Det gör däremot bedömningen möjlig att ifrågasätta.
En användbar förklaring måste göra det möjligt att upptäcka ett fel – inte bara få avslaget att låta rimligt.
5. Hösten 2026: vad AI-förordningen faktiskt säger
Här krävs en tydlig publiceringsreservation. Datumen nedan följer den antagna EU-förordningen 2024/1689. Någon kontroll i realtid av senare ändringsakter, övergångsregler eller aktuell myndighetsvägledning har inte kunnat göras för detta reportage. Inför publicering hösten 2026 måste redaktionen verifiera rättsläget i EUR-Lex och hos ansvariga myndigheter. Ett politiskt förslag om ändrade datum är inte detsamma som en beslutad lagändring.
Enligt den antagna förordningens tidplan ska huvuddelen av reglerna börja tillämpas den 2 augusti 2026. Rekryteringssystem som omfattas av högriskklassningen i bilaga III hör som utgångspunkt till den tidplanen. Datumet den 2 augusti 2027 gäller en annan del av högriskregleringen, kopplad till artikel 6.1 och vissa produktregelverk; det är inte ett generellt startdatum för AI-rekrytering.
Bilaga III tar uttryckligen upp AI-system avsedda för rekrytering eller urval, bland annat att analysera och filtrera ansökningar och utvärdera kandidater. Även riktad placering av platsannonser nämns. För Samira betyder det att lagstiftaren ser urvalsteknik som något som kan påverka människors livschanser, inte bara som administrativ programvara.
Men varje digitalt rekryteringsverktyg är inte högrisk-AI. Först måste det vara ett AI-system enligt förordningen. Artikel 6.3 innehåller dessutom en avgränsad möjlighet att bedöma vissa bilaga III-system som inte högrisk, exempelvis vid vissa snäva proceduruppgifter utan betydande påverkan på beslut. Undantaget kan inte behandlas som en allmän etikett för ”beslutsstöd”. System i bilaga III som profilerar fysiska personer ska alltid anses vara högrisk.
För högrisksystem finns krav på bland annat riskhantering, datastyrning, teknisk dokumentation, loggning, transparens, mänsklig kontroll, noggrannhet, robusthet och cybersäkerhet. Ansvaren är fördelade. Leverantören ska uppfylla produkt- och systemkrav; arbetsgivaren som använder systemet har egna skyldigheter, bland annat kring användning, övervakning och mänsklig kontroll.
Arbetsgivaren kan alltså inte nöja sig med att leverantören säger att produkten är ”EU-kompatibel”. Samtidigt innebär regelverket inte att varje rekryteringssystem måste förhandsgodkännas av en myndighet eller granskas av en oberoende tredje part innan det används.
Övergångsbestämmelserna spelar också roll. Artikel 111 innehåller särskilda regler för högrisksystem som satts på marknaden eller tagits i bruk före den 2 augusti 2026, bland annat kopplade till betydande ändringar av utformningen. Det går därför inte att lova att alla befintliga rekryteringsverktyg omfattas av samtliga nya krav samma dag. För Samiras rättigheter behöver man veta vilket system det är, när det infördes och hur det senare ändrats.
6. Insyn är mer än en ruta om AI
När de relevanta reglerna är tillämpliga ska användare av högrisksystem enligt bilaga III som fattar eller bistår beslut om personer informera de berörda om att de är föremål för användningen. Det är något mer precist än att gömma ”digitala hjälpmedel kan förekomma” i en allmän integritetspolicy.
AI-förordningens artikel 86 innehåller också en rätt till tydliga och meningsfulla förklaringar under vissa förutsättningar. Den gäller berörda beslut som grundas på resultat från vissa högrisksystem och får rättsliga eller liknande betydande effekter som personen anser påverkar hälsa, säkerhet eller grundläggande rättigheter negativt. Förklaringen ska avse AI-systemets roll i beslutsprocessen och beslutets huvudsakliga delar.
Det är ingen garanti för att få se varje modellvikt eller allt affärskänsligt material. Men det är heller inte samma sak som att få höra att ”en algoritm användes”. Rättighetens närmare räckvidd kommer att behöva tolkas i tillsyn och rättspraxis. Den bör inte beskrivas som en generell rätt till mänsklig omprövning av varje AI-assisterat rekryteringsbeslut; den frågan måste skiljas från bland annat GDPR:s artikel 22.
Den brittiska dataskyddsmyndigheten ICO:s rapport om rekryteringsverktyg från 2024 visar varför praktisk kontroll behövs. Myndigheten granskade AI-baserade verktyg för att hitta, gallra och välja kandidater och gav rekommendationer om bland annat rättvisa, dataminimering och tydligare information. Granskningen är brittisk och avgör inte svensk rätt, men den belyser problem som arbetsgivare kan ställa konkreta frågor om.
För Samira skulle ett användbart besked behöva skilja mellan fyra saker: vilka uppgifter som registrerades, vilka kriterier som användes, hur AI-resultatet påverkade urvalet och vad en människa faktiskt gjorde. Om utbildningskravet var utslagsgivande ska svaret inte handla allmänt om ”profilmatchning”. Om ansökan aldrig öppnades på grund av rangordningen bör arbetsgivaren kunna redogöra för den processen.
Här finns en särskild risk med språkmodeller. De kan producera övertygande förklaringar i efterhand utan att dessa troget återger den verkliga beslutsvägen. Ett elegant stycke om Samiras utvecklingspotential är inte dokumentation av vad som hände.
En trovärdig förklaring behöver därför förankras i underlaget: registrerade meriter, aktuella kriterier, den använda systemversionen, resultatet och den dokumenterade mänskliga hanteringen. Annars blir transparensen ännu en automatiserad textprodukt.
7. Vem har makten att ändra svaret?
Samira får till slut kontakt med en rekryterare i vår fiktiva berättelse. Den avgörande frågan är inte om personen är vänlig. Det är om hon kan göra något åt resultatet.
Har hon tid att läsa originalansökan? Får hon bortse från matchningspoängen? Kan hon rätta felaktiga uppgifter och ordna en ny bedömning? Eller är hennes uppdrag bara att förklara varför systemets lista ska stå fast?
Mänsklig kontroll kostar arbetstid. Den kräver kompetens och mandat. Om organisationen mäter rekryterare enbart på hur snabbt tjänster tillsätts kan den undergräva sin egen ambition att granska automatiserade rekommendationer. En människa i arbetsflödet är inte automatiskt en människa med handlingsutrymme.
För arbetsgivaren börjar ett bättre arbetssätt före inköpet. Kraven behöver knytas till arbetsuppgifterna. Systemets träffsäkerhet behöver prövas i relevant användning, inte bara mot leverantörens genomsnitt. Man behöver undersöka felaktiga bortval, skillnader mellan grupper där detta kan göras lagligt och meningsfullt, samt hur tillgängligheten fungerar för personer med funktionsnedsättning.
Ett viktigt test är att granska ett urval av dem som hamnade långt ned, inte bara dem systemet rekommenderade. Annars ser arbetsgivaren främst framgångarna bland de utvalda och missar kvalificerade personer som aldrig fick chansen. Ett gott anställningsutfall bevisar inte att bortvalen var rimliga.
Den arbetssökande kan samtidigt ställa mer precisa frågor än ”använder ni AI?”. Exempelvis: Används automatisk rangordning eller utslagsgivande filter? Bedömer en person alla ansökningar eller bara en del? Hur rättar jag felaktigt registrerade meriter? Vem kontaktar jag för att begära granskning? Spara annonsen, den inskickade ansökan och arbetsgivarens information om personuppgiftsbehandlingen.
Detta är inte en hemlig metod för att besegra ett rekryteringssystem. Det finns ingen universell uppsättning sökord som garanterar en rättvis bedömning. Tydliga rubriker och konkret beskrivna meriter kan underlätta läsningen, men ansvaret för ett rättssäkert urval ligger inte på den sökande att gissa sig till.
Samira kanske fortfarande inte får jobbet. En annan kandidat kan ha starkare erfarenhet av just den arbetsledning tjänsten kräver. Ett rättvist urval är ingen garanti för ett positivt besked.
Skillnaden är om avslaget går att förstå och pröva. Om hennes erfarenhet faktiskt bedömdes. Om ett fel kan upptäckas. Om någon har makt att ändra ett felaktigt resultat.
AI-rekryteringens viktigaste fråga är därför inte bara vem systemet väljer. Den är vem som tar ansvar för dem det väljer bort.
Källor
- Europaparlamentet och Europeiska unionens råd, Förordning (EU) 2024/1689 om harmoniserade regler för artificiell intelligens (2024)
- Europaparlamentet och Europeiska unionens råd, Förordning (EU) 2016/679 (allmän dataskyddsförordning) (2016)
- Article 29 Data Protection Working Party, Guidelines on Automated individual decision-making and Profiling for the purposes of Regulation 2016/679 (2018)
- Jeffrey Dastin, Reuters, Amazon scraps secret AI recruiting tool that showed bias against women (2018)
- Manish Raghavan, Solon Barocas, Jon Kleinberg och Karen Levy, Mitigating Bias in Algorithmic Hiring: Evaluating Claims and Practices (2020)
- Information Commissioner’s Office, AI tools in recruitment: Audit outcomes report (2024)
- U.S. Equal Employment Opportunity Commission, iTutorGroup to Pay $365,000 to Settle EEOC Discriminatory Hiring Suit (2023)
Ställ frågor om "Vem får jobbet när AI sorterar bort ditt CV?". Svaren bygger på tidningens egna artiklar.