Vem äger det som AI skapar?
En bild kan sakna upphovsrätt och ändå kränka någon annans. Så navigerar skapare mellan svenska regler, amerikanska domstolar och Kinas AI-praxis.
AI gör det enkelt att framställa texter, bilder och musik – men inte att avgöra vem som får använda dem. Svaret beror på människans insats, träningsmaterialet, avtalet och landet. Här är rättsläget och de viktigaste vägvalen, med utgångspunkt i augusti 2025.
 Av Ingrid FalkSkribent · Etik och samhälle
En designer skriver en instruktion, väljer bland tjugo AI-bilder och bearbetar resultatet i ett bildprogram. Kunden betalar för en exklusiv kampanjbild. Men vad har kunden egentligen köpt: en fil, en avtalsenlig användningsrätt eller ett upphovsrättsligt skydd som kan stoppa konkurrenterna?
Den typiska situationen rymmer AI-marknadens stora rättighetsproblem. Verktyget kan lova kommersiell användning utan att bilden för den skull får upphovsrätt. Bilden kan sakna eget skydd men ändå ligga för nära någon annans verk. Och modellens träning kan vara omstridd även när just kampanjbilden inte gör intrång.
Det finns alltså inte en fråga om vem som ”äger AI-konst”, utan flera. Den här lägesbilden utgår från augusti 2025. Särskilt rättsfallen och reglernas genomförande förändras snabbt; domar från ett land är inte automatiskt vägledning i ett annat.
Tre rättigheter som ofta blandas ihop
Rätten till resultatet. Upphovsrätt uppstår normalt när en människa skapar ett tillräckligt originellt uttryck. Den skyddar inte en idé eller allmän stil, utan exempelvis en konkret text, bildkomposition eller melodi. Att inneha filen är något annat än att ha ensamrätt till innehållet.
Rätten att använda verktyget. Tjänstens villkor kan tillåta kommersiell användning, reglera rättigheter mellan användaren och leverantören och ibland erbjuda ett begränsat skydd vid intrångskrav. Men ett avtal kan inte skapa upphovsrätt där lagen inte medger den. Det kan inte heller undanröja utomståendes rättigheter.
Rätten till träningsmaterialet. Modellen kan ha utvecklats med böcker, fotografier, musik eller filmer. Huruvida kopieringen under träningen var tillåten är en egen fråga, skild från skyddet för ett visst resultat.
Skillnaden är avgörande. En lagligt tränad modell kan användas för att framställa en intrångsgörande bild. En modell vars träning ifrågasätts kan producera något som inte återger skyddade delar av något identifierbart verk.
Tekniskt lär sig generativa modeller statistiska samband genom att justera stora mängder parametrar. De fungerar inte bara som sökbara bildarkiv, men kan ibland memorera och återge träningsmaterial. Beskrivningen ”AI kopierar alltid” är därför lika missvisande som ”AI kopierar aldrig”. Juridiken måste undersöka både utvecklingsprocessen och det konkreta utfallet.
Människan är utgångspunkten – men var går gränsen?
I Sverige och EU utgår upphovsrätten från mänskligt skapande. EU-domstolens originalitetskrav handlar om upphovspersonens egen intellektuella skapelse, uttryckt genom fria och kreativa val. Ett helt autonomt maskingenererat resultat har därför inte någon självklar upphovsperson och anses normalt inte uppfylla förutsättningarna för upphovsrättsligt verksskydd.
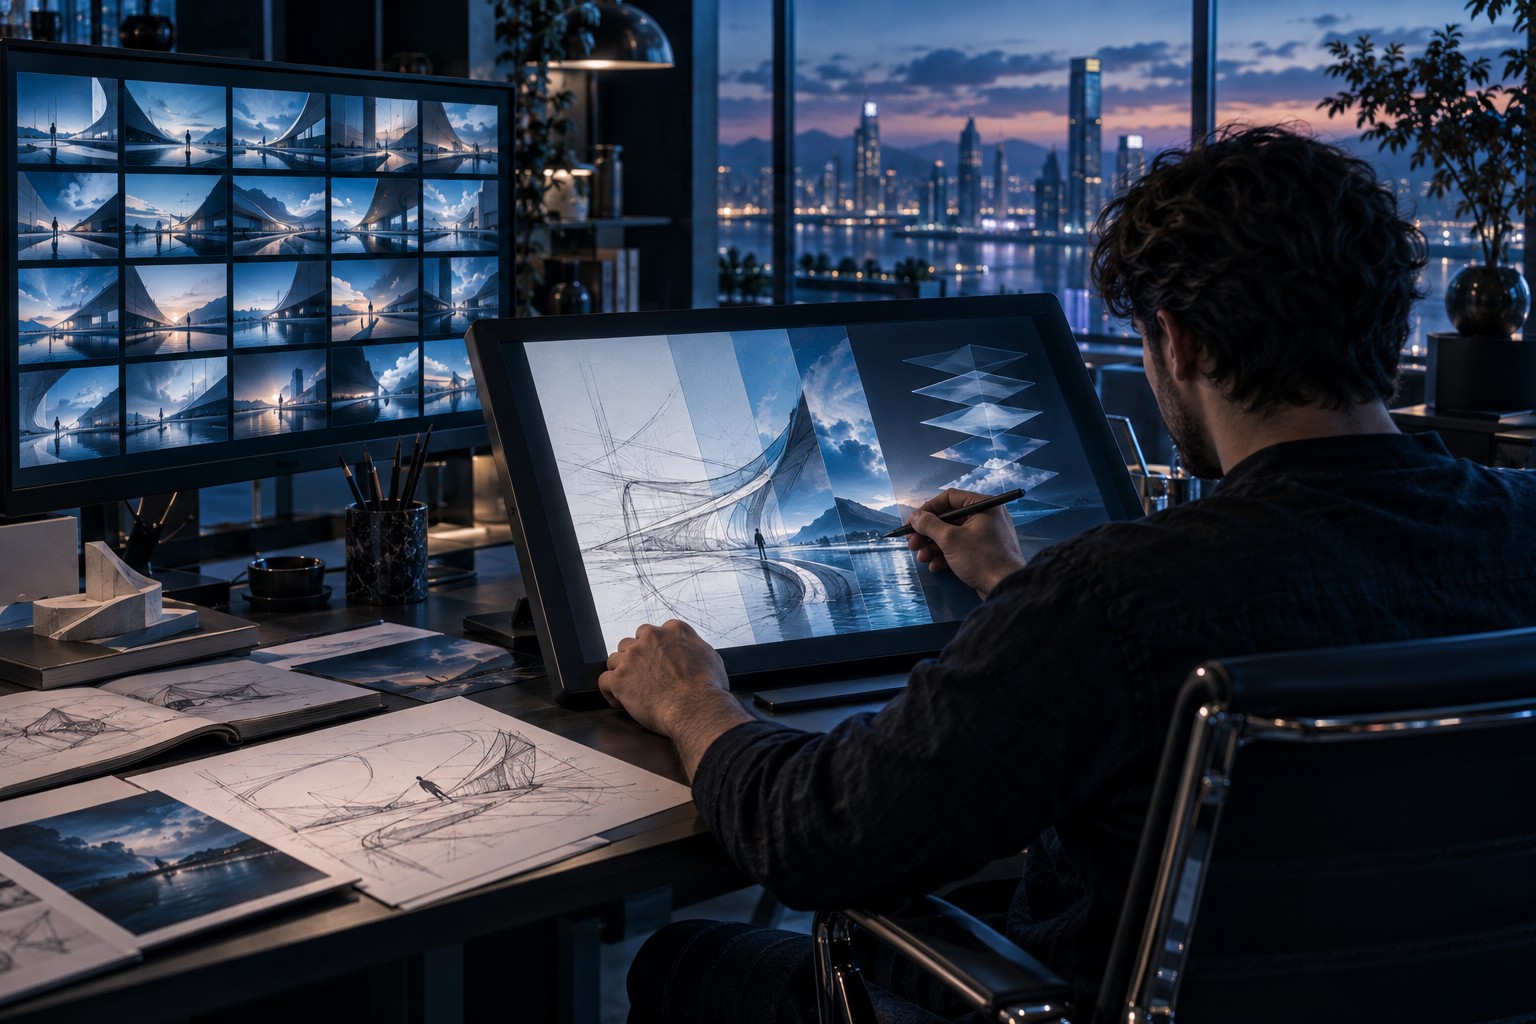
Det betyder inte att allt som passerar ett AI-verktyg blir oskyddat. En författare kan använda AI för korrektur utan att förlora skyddet för romanen. En illustratörs egna teckningar, komposition och omfattande bearbetning kan vara skyddade även när AI ingår i arbetsflödet. Frågan är vilka uttryck människan faktiskt har skapat och kontrollerat.
Amerikanska Copyright Office drog i rapporten Copyright and Artificial Intelligence, Part 2: Copyrightability från januari 2025 en liknande gräns. AI som hjälpmedel utesluter inte skydd. Mänskligt skapade delar, kreativa urval och arrangemang kan skyddas. Men enbart instruktioner till dagens generativa system ger enligt myndigheten normalt inte tillräcklig kontroll över resultatets uttryck.
Tillstånd att använda en AI-bild är inte samma sak som en ensamrätt till bilden.
Det finns ingen säker tumregel om att ett visst antal promptar, arbetstimmar eller procent manuella ändringar räcker. Ett långt arbetsförlopp kan bestå av oskyddade idéer och instruktioner. En kort men originell mänsklig insats kan däremot vara relevant. Amerikansk registreringspraxis är dessutom inte svensk lag.
Storbritannien har en särskild komplikation: upphovsrättslagen innehåller regler för datorgenererade litterära, dramatiska, musikaliska och konstnärliga verk utan mänsklig upphovsperson. Som upphovsperson pekas den ut som vidtar de arrangemang som behövs för skapandet. Hur bestämmelsen fungerar för moderna generativa modeller, tillsammans med originalitetskravet, är dock omstritt.
I Kina fick ett uppmärksammat mål ett annat utfall. Beijing Internet Court erkände 2023 upphovsrätt till en AI-genererad bild efter att ha bedömt användarens konkreta val av instruktioner, parametrar och resultat. Domen visar att mänskliga insatser kan bedömas annorlunda, inte att alla AI-bilder automatiskt är skyddade i Kina. Ett enskilt avgörande bör inte läsas som ett globalt frikort.
För en internationell kampanj kan samma produkt alltså möta olika rättsliga bedömningar. Avtalet med kunden bör inte lova större exklusivitet än skaparen rimligen kan leverera.
Träningsdata: tillstånd, undantag och makt
Upphovspersonernas invändning är enkel att förstå: deras arbete kan användas för att bygga produkter som konkurrerar med dem, utan individuell förhandling eller betalning. Utvecklarna invänder att maskinell analys behövs för forskning och innovation, och att tillstånd från varje rättighetshavare kan vara praktiskt omöjligt.
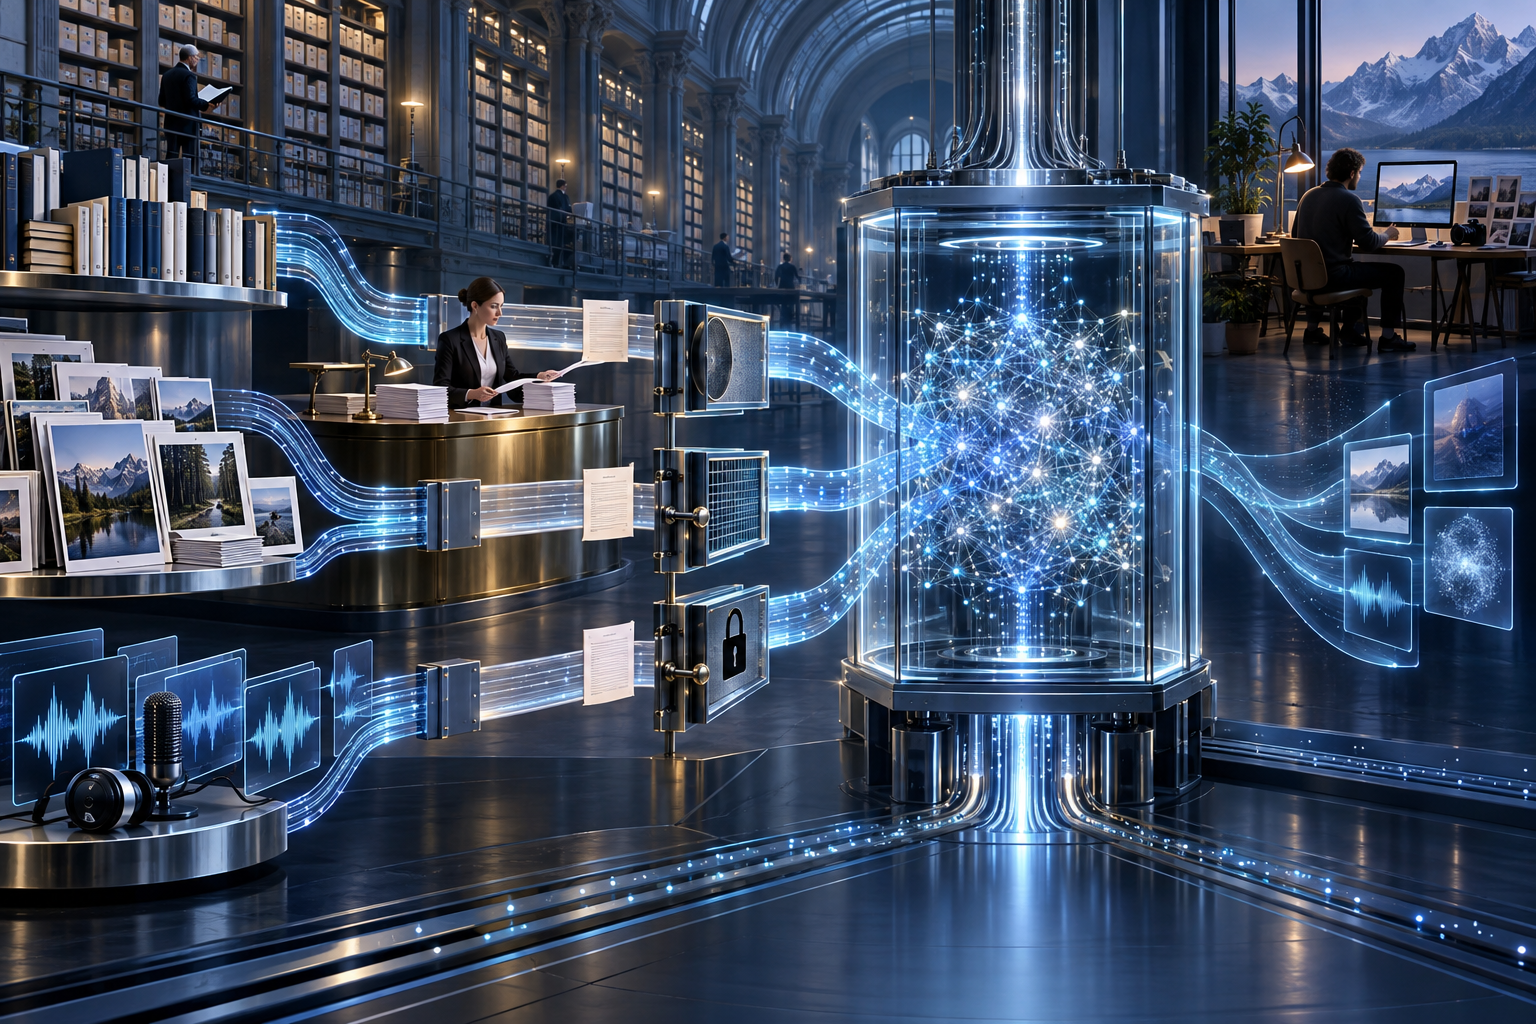
EU har försökt hantera motsättningen genom regler om text- och datautvinning. Upphovsrättsdirektivet från 2019 innehåller ett särskilt undantag för forskningsorganisationer och kulturarvsinstitutioner, under angivna villkor. Ett annat undantag kan användas bredare, även kommersiellt, när materialet är lagligen tillgängligt och rättighetshavaren inte på lämpligt sätt har förbehållit sig rättigheterna.
För material som är offentligt tillgängligt på nätet anger direktivet att förbehållet ska göras på ett lämpligt sätt, exempelvis maskinläsbart. Men exakt vilka signaler som räcker och hur de ska upptäckas och respekteras är viktiga praktiska tvistefrågor. Att en sida går att öppna i en webbläsare betyder inte att varje efterföljande användning är tillåten.
Hur dessa regler ska tillämpas på olika steg i generativ AI-träning är inte slutligt klarlagt i alla avseenden. Rättighetsförbehåll, laglig tillgång och kopieringens karaktär behöver prövas konkret. Ett förbehåll är inte heller i sig ett löfte om ersättning eller en automatisk order att radera redan inlärda samband.
I USA står i stället fair use i centrum. Bedömningen väger bland annat användningens syfte, verkets karaktär, mängden som används och effekten på marknaden. Det är ingen generell licens för teknikföretag, men heller inget automatiskt förbud mot träning utan tillstånd.
I Bartz v. Anthropic i juni 2025 bedömde en federal distriktsdomstol att den aktuella användningen av böcker för modellträning omfattades av fair use. Samtidigt godtog domstolen inte uppbyggnaden av ett permanent bibliotek med piratkopierade böcker på samma grund. Avgörandet skilde alltså mellan träningens syfte och hur böcker hade införskaffats och lagrats.
Det var ett viktigt men begränsat avgörande, inte ett slutligt amerikanskt besked om all AI-träning. Andra faktaunderlag, skador och överklaganden kan ge andra resultat. Copyright Offices preliminära rapport om träning från maj 2025 betonar också att användningarna varierar och måste bedömas därefter.
Licensavtal erbjuder en väg framåt, men skapar nya fördelningsfrågor. Stora förlag och bildbyråer kan förhandla; enskilda frilansare har sämre förutsättningar. Dyra datalicenser kan samtidigt stärka de största AI-bolagen på mindre aktörers bekostnad. Rättvisa för skapare och öppen konkurrens sammanfaller inte alltid.
AI-förordningen löser inte ägandefrågan
EU:s AI-förordning är inte en ny upphovsrättslag. Den avgör inte vem som är upphovsperson till en genererad roman eller om ett visst träningsförfarande är tillåtet. Däremot skapar den skyldigheter som kan göra utvecklingen mer genomlyst.
För leverantörer av AI-modeller för allmänna ändamål omfattar reglerna bland annat en policy för att följa EU:s upphovsrätt, inklusive relevanta rättighetsförbehåll. Leverantörerna ska också offentliggöra en tillräckligt detaljerad sammanfattning av innehållet som använts för träningen, enligt en mall från AI-byrån.
Bestämmelserna börjar tillämpas den 2 augusti 2025, med särskilda övergångsregler. För modeller som redan släppts ut på marknaden före detta datum gäller i huvudsak en anpassningsfrist till den 2 augusti 2027. Tidpunkterna spelar roll: en skyldighet i förordningstexten är inte alltid en skyldighet som redan gäller för varje modell.
Träningssammanfattningen ska inte förväxlas med en fullständig, offentligt sökbar förteckning över varje verk. Den ger inte heller automatiskt upphovspersonen ersättning eller bevisar att en viss bok användes. Transparens kan underlätta granskning, men omfattningen och användbarheten blir avgörande.
Förordningens särskilda transparensregler för bland annat deepfakes börjar generellt tillämpas i augusti 2026. Även här är kategorierna viktiga: upphovsrätt, information om syntetiskt innehåll och skydd mot vilseledande framställningar är olika rättsliga frågor.
Storbritannien hade i augusti 2025 ännu inte slutfört den reform som diskuterats i regeringens samråd Copyright and Artificial Intelligence. Ett förslag om ett bredare undantag med möjlighet till rättighetsförbehåll ska därför inte beskrivas som gällande lag. Det illustrerar ett återkommande problem i debatten: politiska avsikter marknadsförs lätt som färdiga spelregler.
Musik, film och ansikten har fler rättighetslager
För musik räcker det inte att fråga vem som skrev melodin. Komposition, sångtext och en viss ljudinspelning kan omfattas av olika rättigheter. Artister och producenter kan ha närstående rättigheter. En syntetisk låt kan därför kräva flera separata bedömningar.
En musikalisk stil skyddas normalt inte i sig av upphovsrätten. Däremot kan en igenkännbar skyddad melodi eller återanvänd inspelning innebära intrång. En röstimitation aktualiserar dessutom andra frågor: personuppgifter, vilseledande marknadsföring och, beroende på land, särskilda personlighetsskydd. En röst är inte automatiskt ett upphovsrättsligt verk.
I Sverige finns särskilda regler om namn och bild i reklam. GDPR kan bli relevant när identifierbara människor förekommer i materialet eller behandlas av tjänsten. Att uppladdningen sker för ett kreativt projekt befriar inte en verksamhet från krav på rättslig grund, information och säker hantering.
Film innehåller ofta ännu fler lager: manus, musik, bilder, framföranden och producenters rättigheter. AI-förlängning av en scen eller syntetisk dubbning kan också beröras av avtal med medverkande. Ett tillstånd att visa originalfilmen innebär inte självklart rätt att skapa nya digitala framföranden.
Här möts upphovsrätt och demokrati. Samma verktyg kan göra små produktioner möjliga och låta en människa framstå som avsändare för något hon aldrig sagt. Frågan är inte bara vem som tjänar pengar, utan vem som får kontrollera sitt uttryck och sin offentliga identitet.
Så minskar skaparen risken
Det går att arbeta med AI utan att invänta varje dom. Men arbetsflödet behöver visa vad som är mänskligt skapat, vad leverantören lovar och vilka externa rättigheter som berörs.
- Spara den mänskliga processen. Bevara utkast, egna original, lagerfiler och betydelsefulla bearbetningar. Promptloggar kan ge sammanhang, men bevisar inte ensamma upphovsrätt.
- Läs rätt villkor. Kontrollera kommersiell användning, abonnemangsnivå, leverantörens rätt till uppladdat material och eventuella undantag i skyddet mot intrångskrav. Spara den version som gällde.
- Ladda bara upp sådant du får använda. Kundmaterial, opublicerade manus och personbilder kan omfattas av sekretess, avtal eller dataskydd även om du har tillgång till filerna.
- Granska resultatet. Kontrollera misstänkt igenkännbara passager, figurer, logotyper, melodier och ansikten. Bildsökning eller likhetskontroller kan hjälpa, men garanterar inte rättslig säkerhet.
- Avtala om rätt sak. Beskriv AI-inslaget och vilka rättigheter som faktiskt överlåts. Skilj mellan rätt att använda leveransen och ett löfte om exklusivitet. Fördela ansvar för godkännande och eventuella krav.
- Anpassa kontrollen till insatsen. Ett internt skissutkast och en internationell reklamkampanj motiverar olika granskningsnivåer. Vid värdefulla eller personkänsliga produktioner är juridisk granskning ofta billigare än en senare tvist.
För designern i början är slutsatsen inte att AI-bilden måste kastas. Den är att kunden behöver ett ärligt besked om vad leveransen innehåller och vilket skydd som är osäkert. Framtidens kreativa yrkesskicklighet blir också förmågan att hålla isär teknisk möjlighet, avtalslöfte och faktisk rätt.
Källor
- Europaparlamentet och Europeiska unionens råd, Europaparlamentets och rådets förordning (EU) 2024/1689 (2024)
- Europaparlamentet och Europeiska unionens råd, Europaparlamentets och rådets direktiv (EU) 2019/790 (2019)
- U.S. Copyright Office, Copyright and Artificial Intelligence, Part 2: Copyrightability (2025)
- U.S. Copyright Office, Copyright and Artificial Intelligence, Part 3: Generative AI Training (2025)
- United States District Court for the Northern District of California, Bartz v. Anthropic PBC, Order on Fair Use, No. 3:24-cv-05417-WHA (2025)
- UK Intellectual Property Office, Department for Science, Innovation and Technology och Department for Culture, Media and Sport, Copyright and Artificial Intelligence (2024)
- Beijing Internet Court, Li v. Liu, (2023) Jing 0491 Min Chu No. 11279 (2023)
- Sveriges riksdag, Lag (1960:729) om upphovsrätt till litterära och konstnärliga verk (1960)
Ställ frågor om "Vem äger det som AI skapar?". Svaren bygger på tidningens egna artiklar.